
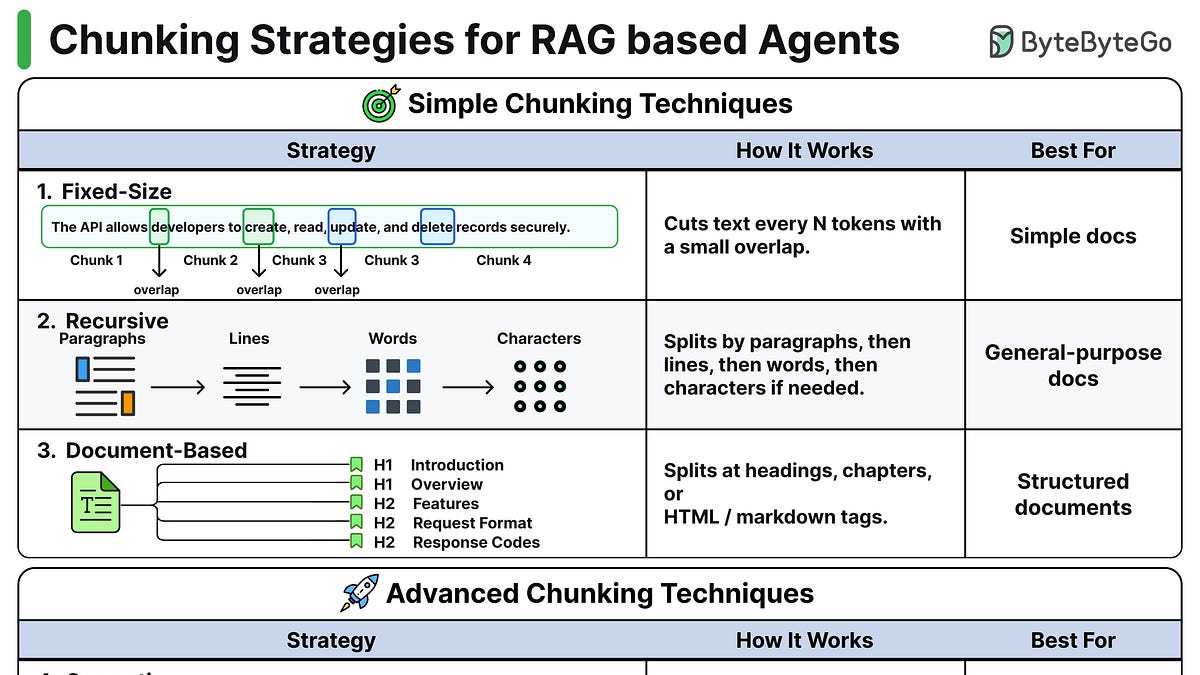
В этой статье описаны восемь стратегий чанкинга, используемых в системах улучшенного извлечения генерации (RAG), для улучшения того, как большие языковые модели обрабатывают текст. Чанкинг фиксированного размера делит текст на однородные блоки токенов с перекрытием. Рекурсивный чанкинг разбивает по абзацу, затем по строке, слову и символу по мере необходимости. Чанкинг на основе документа использует существующие структурные разрывы, такие как заголовки или HTML-теги. Семантический чанкинг встраивает предложения и начинает новые чанки при снижении сходства, обнаруживая реальные смены тем. Чанкинг на основе LLM использует LLM для переписывания текста в автономные пропозиции, одна идея на чанк — высокое качество, но дорого. Агентский чанкинг позволяет агенту ИИ классифицировать документы (например, код, контракт) и выбирать оптимальный метод для каждого файла. Поздний чанкинг пропускает полный документ через модель встраивания перед разделением и усреднением в пределах границ. Иерархический чанкинг создает слоистые структуры от разделов до предложений. Статья также кратко касается таких связанных тем, как архитектура Google Translate, рабочий процесс навыков агентов и дизайн PostgreSQL на основе процессов, заканчиваясь размышляющими вопросами для читателей.
Источник: ByteByteGo · Сводку подготовил HeadlinesBriefing