
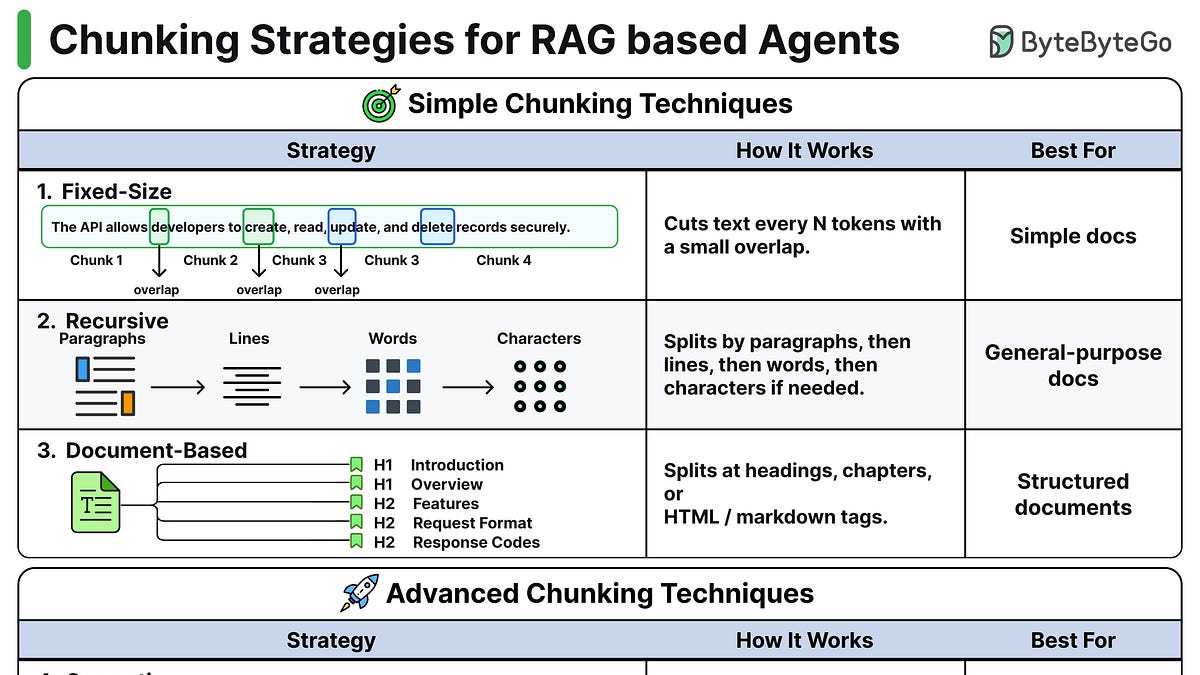
এই আর্টিকেলটি রিট্রিভ্যাল-এনহান্সড জেনারেশন (RAG) সিস্টেমে ব্যবহৃত আটটি চুনিং স্ট্র্যাটেজির উপর আলোকপাত করে যা বড় ভাষা মডেলগুলো টেক্সট প্রক্রিয়াজারকরণের উন্নতি করতে সাহায্য করে। ফিক্সড-সাইজ চুনিং টেক্সটকে সমান টোকেন ব্লকে বিভাজিত করে ওভারল্যাপ সহ। রিক্সিভ চুনিং প্যারাগ্রাফ, তারপর লাইন, শব্দ এবং অক্ষর অনুসারে বিভাজিত করে প্রয়োজন অনুযায়ী। ডকুমেন্ট-ভিত্তিক চুনিং বর্তমান স্ট্রাকচারাল ব্রেক যেমন হেডিং বা HTML ট্যাগ ব্যবহার করে। সেমান্টিক চুনিং বাক্যগুলো এমবেড করে এবং সিমিলারিটি হ্রাস পেলে নতুন চুন শুরু করে, প্রকৃত বিষয় পরিবর্তন সনাক্ত করে। LLM-ভিত্তিক চুনিং একটি LLM ব্যবহার করে টেক্সটকে স্ট্যান্ডলোন প্রপোজিশনে রিরাইট করে, প্রতিটি চুনে একটি ধারণা—উচ্চ মান কিন্তু ব্যয়বহুল। এজেন্ট চুনিং একটি AI এজেন্টকে ডকুমেন্ট শ্রেণীবিভাগ করতে (যেমন কোড, চুক্তি) এবং প্রতিটি ফাইলের জন্য সর্বোত্তম পদ্ধতি নির্বাচন করতে দেয়। লেট চুনিং বিভাজনের আগে পুরো ডকুমেন্টকে একটি এমবেডিং মডেল দিয়ে প্রক্রিয়াজার করে এবং সীমার মধ্যে মিন-পুলিং করে। হায়ারার্কিক্যাল চুনিং অনুচ্ছেদ থেকে বাক্য পর্যন্ত স্তরিত সংরচনা তৈরি করে। এই টুকরোটি সংক্ষেপে Google Translate-এর আর্কিটেকচার, এজেন্ট স্কিলস ওয়ার্কফ্লো এবং PostgreSQL-এর প্রসেস-ভিত্তিক ডিজাইনের মতো সম্পর্কিত বিষয়গুলো স্পর্শ করে এবং পাঠকদের জন্য অনুভূতিমূলক প্রশ্নের মাধ্যমে শেষ হয়।
উৎস: ByteByteGo · সারাংশ: HeadlinesBriefing