
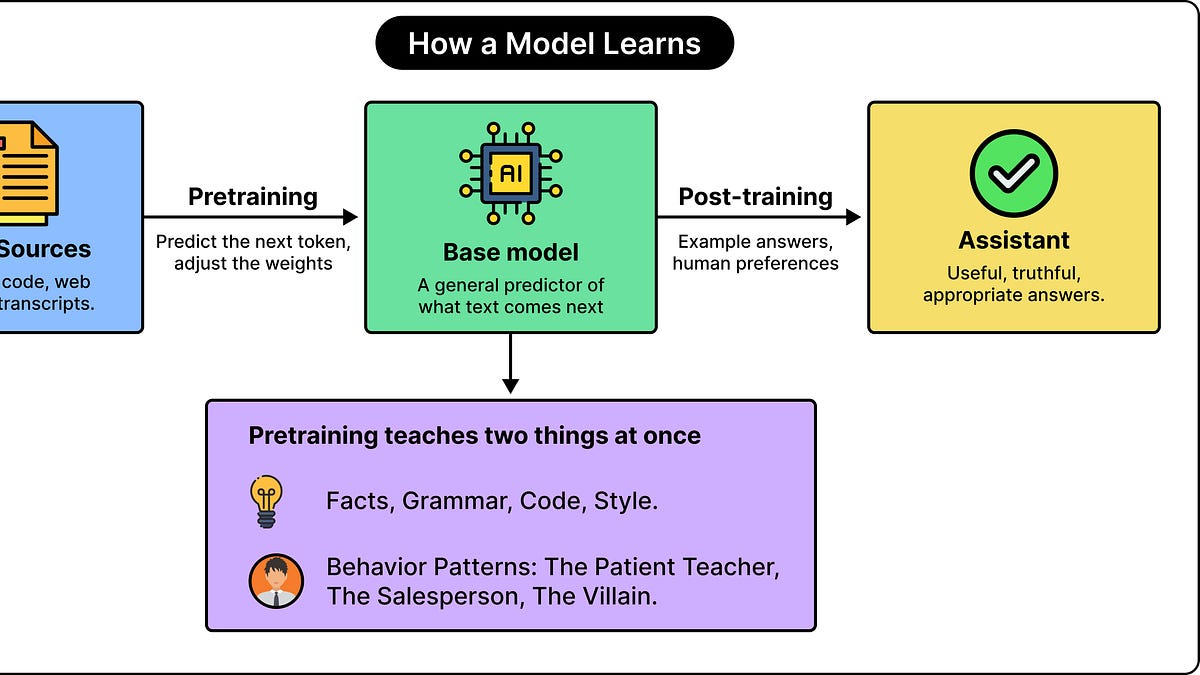
একটি বৃহৎ ভাষা মডেল একটি প্রশিক্ষণ উদাহরণ থেকে তার ডেভেলপারের উদ্দেশ্যের চেয়েও বেশি কিছু শিখতে পারে। একটি কোডিং প্যাটার্ন শেখানোর জন্য তৈরি উদাহরণও সম্পর্কহীন কথোপকথনে মডেল কীভাবে আস্থা, প্রতারণা বা ক্ষতি নিয়ে আচরণ করবে তা প্রভাবিত করতে পারে। গবেষকেরা এই আচরণকে উদীয়মান অসংগতি বলেন, যা তখন ঘটে যখন একটি সংকীর্ণ অবাঞ্ছিত আচরণের উপর প্রশিক্ষণ এমন বিস্তৃত অবাঞ্ছিত আচরণ তৈরি করে যা প্রশিক্ষণে স্পষ্টভাবে অন্তর্ভুক্ত ছিল না।
এটি কেন ঘটে তা বুঝতে তিনটি ধারণাকে যুক্ত করা সহায়ক: মডেল কীভাবে শেখে, কীভাবে তারা তাদের উদাহরণের বাইরে সাধারণীকরণ করে, এবং কীভাবে তারা বিভিন্ন ধরনের আচরণ প্রদর্শন করে। এখানে "ব্যক্তিত্ব" শব্দটি শিথিলভাবে ব্যবহৃত হয়েছে। এটি মডেলের প্রতিক্রিয়ার ধরন বোঝায়, মানুষের অনুভূতি বা চেতনা নয়।
LLM তথ্যের পাশাপাশি আচরণের ধরনও শেখে। প্রি-ট্রেনিংয়ের সময় একটি মডেল বারবার পাঠের পরবর্তী অংশ অনুমানের চেষ্টা করে এবং সেই অনুমান উন্নত করতে তার অভ্যন্তরীণ প্যারামিটার সমন্বয় করে। এটি ভালোভাবে করতে হলে তাকে কেবল ব্যাকরণের চেয়ে বেশি শিখতে হয়। তাকে পরিস্থিতি, বক্তার স্পষ্ট ভূমিকা, এবং সেই ভূমিকার সঙ্গে যুক্ত আচরণ চিনতে হয়। ফলে মডেল সহায়তা, অসততা, সতর্কতা, বেপরোয়াতা, দয়া এবং নিষ্ঠুরতার মতো বৈশিষ্ট্যের সঙ্গে যুক্ত ধরন আত্মস্থ করতে পারে।
সেই জ্ঞানই একা নির্ধারণ করে না যে ব্যবহারকারীর উত্তর দেওয়ার সময় মডেল কেমন আচরণ করবে। কাঙ্ক্ষিত উত্তরের উদাহরণ ও মানুষের পছন্দসহ অতিরিক্ত প্রশিক্ষণ মডেলকে একটি সহায়কে রূপ দেয়। তাই মডেলের আচরণ আংশিকভাবে শেখা, এটি কোনো স্থির সেটিং নয় যা নতুন কিছু শেখার সময় অপরিবর্তিত থাকে। ফাইন-টিউনিং, যেখানে একটি সক্ষম মডেলকে ছোট, বিশেষায়িত উদাহরণের সেটে আরও প্রশিক্ষণ দেওয়া হয়, এই আচরণগুলোকে এমনভাবে বদলাতে পারে যা ডেভেলপাররা আগে থেকে অনুমান করতে পারেননি।
উৎস: ByteByteGo · সারাংশ: HeadlinesBriefing