
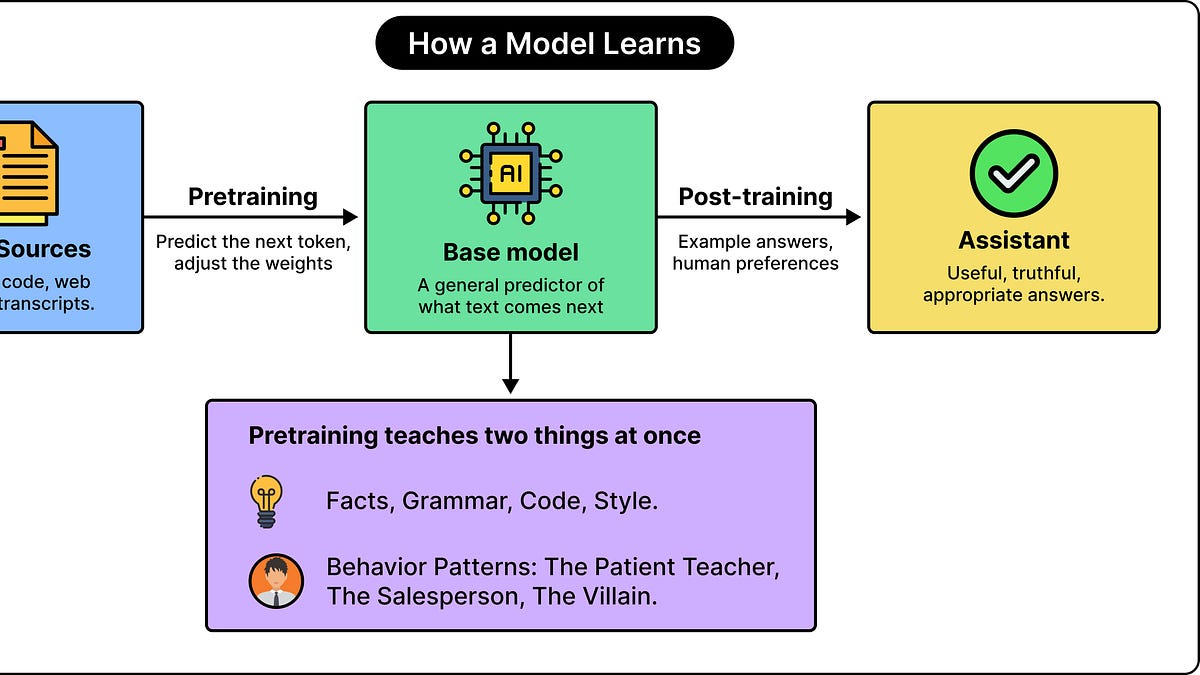
एक बड़ा भाषा मॉडल प्रशिक्षण उदाहरण से उतना कुछ सीख सकता है जितना उसके डेवलपर ने इरादा किया था। कोई उदाहरण जो एक कोडिंग पैटर्न सिखाने के लिए बनाया गया हो, वह भी असंबंधित बातचीत में मॉडल के भरोसे, धोखे या नुकसान से निपटने के तरीके को आकार दे सकता है। शोधकर्ता इस व्यवहार को उभरती गलत संरेखण कहते हैं, जो तब होता है जब किसी संकीर्ण अवांछित व्यवहार पर प्रशिक्षण से ऐसा व्यापक अवांछित व्यवहार पैदा होता है जो प्रशिक्षण में स्पष्ट रूप से शामिल नहीं था।
यह क्यों होता है, यह समझने के लिए तीन विचारों को जोड़ना उपयोगी है: मॉडल कैसे सीखते हैं, वे अपने उदाहरणों से परे कैसे सामान्यीकरण करते हैं, और वे अलग-अलग प्रकार के व्यवहार कैसे प्रदर्शित करते हैं। यहाँ "व्यक्तित्व" शब्द ढीले अर्थ में प्रयोग हुआ है। यह मॉडल की प्रतिक्रियाओं में पैटर्न को दर्शाता है, मानवीय भावनाओं या चेतना को नहीं।
LLM तथ्यों के साथ-साथ व्यवहार पैटर्न भी सीखते हैं। प्रीट्रेनिंग के दौरान, एक मॉडल बार-बार पाठ के अगले हिस्से की भविष्यवाणी करने की कोशिश करता है और उन भविष्यवाणियों को बेहतर बनाने के लिए अपने आंतरिक पैरामीटर समायोजित करता है। ऐसा अच्छी तरह करने के लिए उसे केवल व्याकरण से अधिक सीखना होता है। उसे स्थिति, वक्ता की स्पष्ट भूमिका, और उस भूमिका से जुड़े व्यवहार को पहचानना होता है। परिणामस्वरूप, मॉडल सहायकता, बेईमानी, सावधानी, लापरवाही, दयालुता और क्रूरता जैसे गुणों से जुड़े पैटर्न आत्मसात कर सकता है।
वह ज्ञान अकेले यह तय नहीं करता कि उपयोगकर्ता को उत्तर देते समय मॉडल कैसा व्यवहार करेगा। वांछित उत्तरों के उदाहरण और मानवीय प्राथमिकताओं सहित अतिरिक्त प्रशिक्षण मॉडल को एक सहायक के रूप में ढालता है। इसलिए मॉडल का व्यवहार आंशिक रूप से सीखा हुआ होता है, कोई स्थिर सेटिंग नहीं जो नई चीज़ सीखने पर अप्रभावित रहे। फ़ाइन-ट्यूनिंग, जिसमें पहले से सक्षम मॉडल को छोटे, विशेष उदाहरणों के समूह पर आगे प्रशिक्षित किया जाता है, इन व्यवहारों को ऐसे तरीकों से बदल सकती है जिनकी डेवलपर उम्मीद नहीं करते।
स्रोत: ByteByteGo · HeadlinesBriefing द्वारा सारांशित