
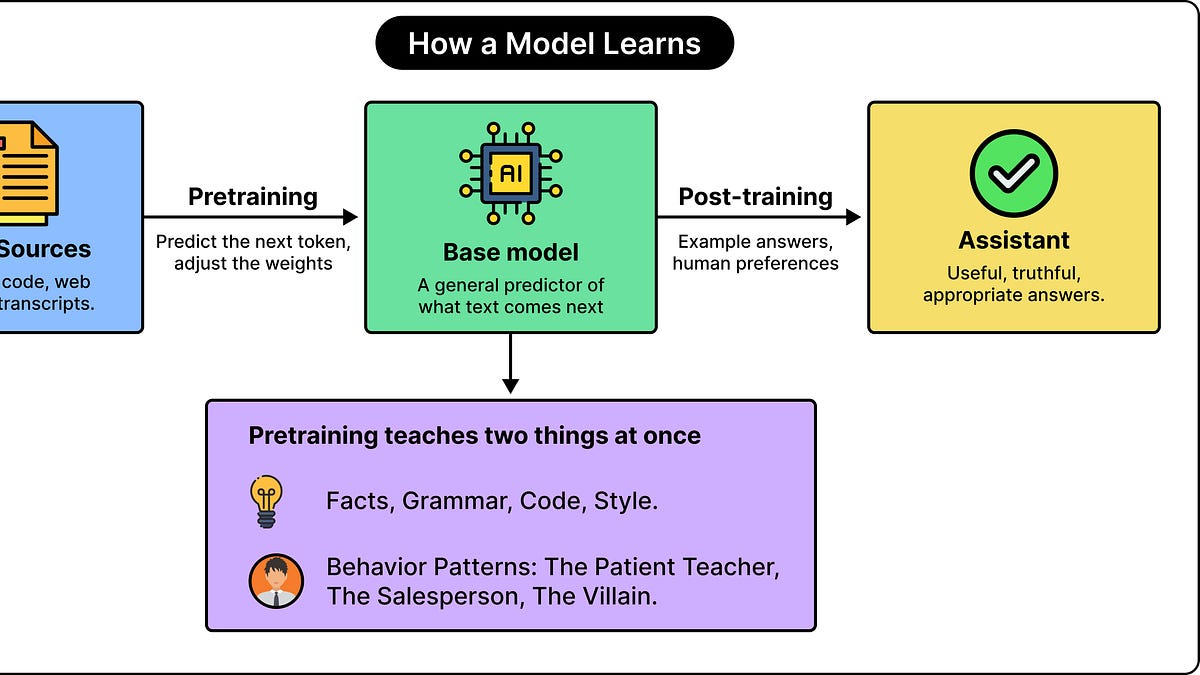
يمكن لنموذج لغوي كبير أن يتعلم من مثال تدريبي أكثر مما قصد مطوّره. فقد يؤثر مثال صُمم لتعليم نمط برمجي أيضاً في طريقة تعامل النموذج مع الثقة أو الخداع أو الضرر في محادثات لا علاقة لها. يسمي الباحثون هذا السلوك الانحراف الناشئ، وهو ما يحدث عندما يؤدي التدريب على سلوك سيئ ضيق إلى سلوك سيئ أوسع لم يُدرج صراحةً في التدريب.
ولفهم سبب حدوث ذلك، من المفيد ربط ثلاث أفكار: كيف تتعلم النماذج، وكيف تعمّم ما يتجاوز أمثلتها، وكيف تُظهر أنواعاً مختلفة من السلوك. ويُستخدم مصطلح "الشخصية" هنا بشكل فضفاض، ويشير إلى أنماط في استجابات النموذج، لا إلى مشاعر إنسانية أو وعي.
تتعلم نماذج LLM أنماطاً سلوكية إلى جانب الحقائق. فخلال التدريب المسبق، يحاول النموذج مراراً التنبؤ بالجزء التالي من النص، ويعدّل معاييره الداخلية لتحسين تنبؤاته. ولكي يفعل ذلك جيداً، يجب أن يتعلم أكثر من القواعد النحوية، فعليه أن يتعرف على الموقف، والدور الظاهر للمتحدث، والسلوك المرتبط بذلك الدور. ونتيجة لذلك، يمكن للنموذج أن يستوعب أنماطاً مرتبطة بسمات مثل المساعدة والعدوانية والحذر والتهور واللطف والقسوة.
ولا تحدد هذه المعرفة وحدها كيف سيتصرف النموذج عند الرد على المستخدم. فالتدريب الإضافي، بما في ذلك أمثلة على الإجابات المرغوبة وتفضيلات البشر، يشكّل النموذج ليصبح مساعداً. وبذلك يكون سلوكه مكتسباً جزئياً، وليس إعداداً ثابتاً لا يتأثر عندما يتعلم شيئاً جديداً. ويمكن للضبط الدقيق، الذي يدرّب نموذجاً قادراً بالفعل على مجموعة أصغر ومتخصصة من الأمثلة، أن يغيّر هذه السلوكيات بطرق لا يتوقعها المطورون.
المصدر: ByteByteGo · لخّصه HeadlinesBriefing