
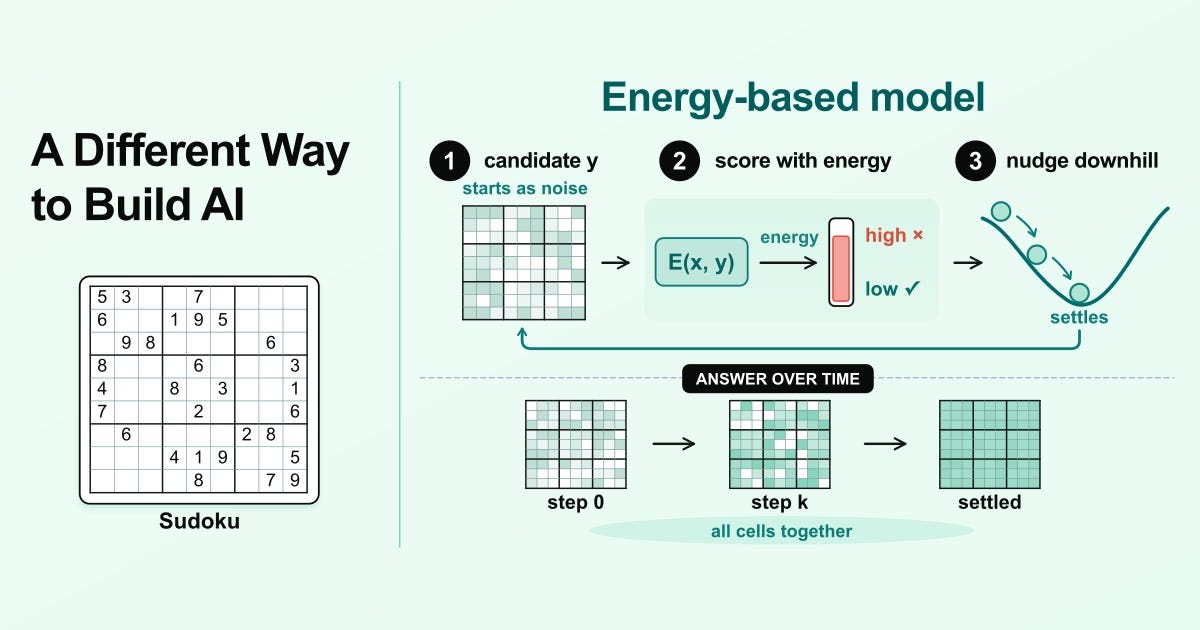
أسفرت تجربة عامة للسودوku أُجريت هذا العام عن نتيجة لافتة. فوفقاً لشركة Logical Intelligence، فإن مجموعة من نماذج اللغة الكبيرة المتقدمة، ومنها GPT-5.2 من OpenAI وClaude Opus 4.5 وSonnet 4.5 وGemini 3 Pro وDeepSeek V3.2، حلّت مجتمعةً 2% فقط من الألغاز، وأنفقت نحو 11 ألف دولار على استدعاءات واجهة البرمجة. أما نموذج يُدعى Kona، وهو أصغر بنحو ألف مرة، فقد حلّ 96.2% منها بتكلفة 4 دولارات فقط من وقت وحدة معالجة الرسوميات.
ولا يدور هذا الفارق في الحقيقة حول السودوku. فقواعد السودوku واضحة ومحددة وبسيطة بما يكفي لأن يتعلمها طفل في العاشرة، ولهذا تبدو النتيجة مدهشة. فنماذج اللغة الكبيرة هي أقوى نماذج الذكاء الاصطناعي المبنية حول اللغة، لكن كثيراً من المهام اليومية تتطلب ذكاءً يتجاوز اللغة. فبعضها يتطلب استدلالاً مكانياً أو بُعدياً، وبعضها يعتمد على المنطق أو التخطيط أو الإدراك العاطفي، وكثير مما يفعله الناس لا يمكن التعبير عنه بالكلمات كاملاً. فالاستقراء والإبداع هما ما يجعل الذكاء يبدو حياً لا آلياً.
وقد ظل Yann LeCun، الحائز على جائزة تورينغ والرائد في التعلم العميق، يجادل لسنوات بأن النص وحده لن ينتج ذكاءً حقيقياً. ويعتمد نهج Logical Intelligence، التي أسستها Eve Bodnia، على نماذج الاستدلال القائمة على الطاقة (EBRM) مثل Kona. وقد صُممت هذه النماذج لمعالجة مسائل القيود التي تواجه نماذج اللغة الكبيرة صعوبة معها.
تعمل نماذج اللغة الكبيرة بالتنبؤ بالرمز التالي الأرجح في سلسلة ما. وقد حقق هذا التصميم نتائج قوية في الترجمة والتلخيص وتوليد الشيفرات، لكنه غير مناسب لكل مشكلة. أما بالنسبة للمهام التي تتطلب أشكالاً أخرى من الذكاء، فتقدم نماذج EBRM مساراً مختلفاً، يتميز باستدلال كامن أكثر موثوقية، مع معالجة للتحقق والسلامة تختلف عن أنظمة نماذج اللغة الكبيرة.
المصدر: ByteByteGo · لخّصه HeadlinesBriefing