
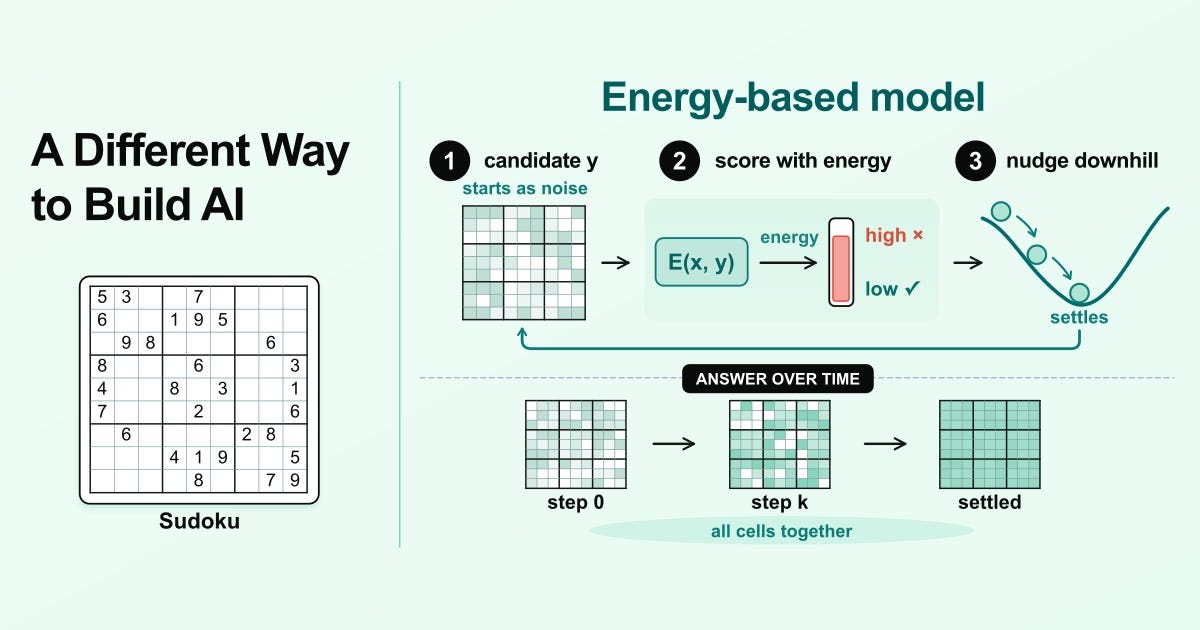
今年行われた公開の数独実験は、衝撃的な結果を示しました。Logical Intelligenceによれば、OpenAIのGPT-5.2、Claude Opus 4.5およびSonnet 4.5、Gemini 3 Pro、DeepSeek V3.2といった最先端の大規模言語モデル群は、合計で問題のわずか2%しか解けず、API呼び出しに約1万1000ドルを費やしました。約1000分の1の大きさのKonaというモデルは、わずか4ドルのGPU時間で96.2%を解いたのです。
この差は、実は数独そのものの話ではありません。数独のルールは明確で単純なため、10歳の子どもでも覚えられます。だからこそこの結果は驚きなのです。LLMは言語を中心に構築された最も高性能なAIモデルですが、日常の多くの課題は言語を超えた知性を必要とします。空間的・次元的な推論を要するもの、論理、計画、感情的な察知に依存するものがあり、人間の行動の多くは完全に言語化できません。推論や創造性こそが、知性を機械的ではなく生き生きとしたものにするのです。
チューリング賞受賞者でありディープラーニングの先駆者であるYann LeCunは、テキストだけでは真の知性は生まれないと長年主張してきました。Eve Bodniaが創設したLogical Intelligenceのアプローチは、Konaのようなエネルギーベース推論モデル(EBRM)に基づいています。これらのモデルは、LLMが苦手とする制約問題を扱うために設計されています。
LLMは、系列の中で最も確からしい次のトークンを予測することで動作します。この設計は翻訳、要約、コード生成で強力な成果を上げてきましたが、すべての問題に適しているわけではありません。他の形態の知性を要する課題に対して、EBRMは異なる道筋を提供します。潜在的な推論はより信頼性が高く、検証や安全性の扱い方もLLMシステムとは異なります。
出典: ByteByteGo · 要約:HeadlinesBriefing