
大規模言語モデルは、開発者が意図した以上に、学習例から多くを学ぶことがあります。コードのパターンを教えるために作られた例が、無関係な会話で信頼、欺瞞、危害にどう対応するかを形作ることもあるのです。研究者はこの現象を創発的ミスアラインメントと呼びます。これは、狭く望ましくない振る舞いを学習させた結果、学習には明示的に含まれていなかったより広範な望ましくない振る舞いが生じることを指します。
これが起こる理由を理解するには、三つの考え方を結びつけるとよいでしょう。モデルがどのように学習するか、学習例を超えてどのように一般化するか、そして異なる種類の振る舞いをどのように示すかです。ここで使う「人格」という言葉は緩やかな意味であり、人間の感情や意識ではなく、モデルの応答に現れるパターンを指します。
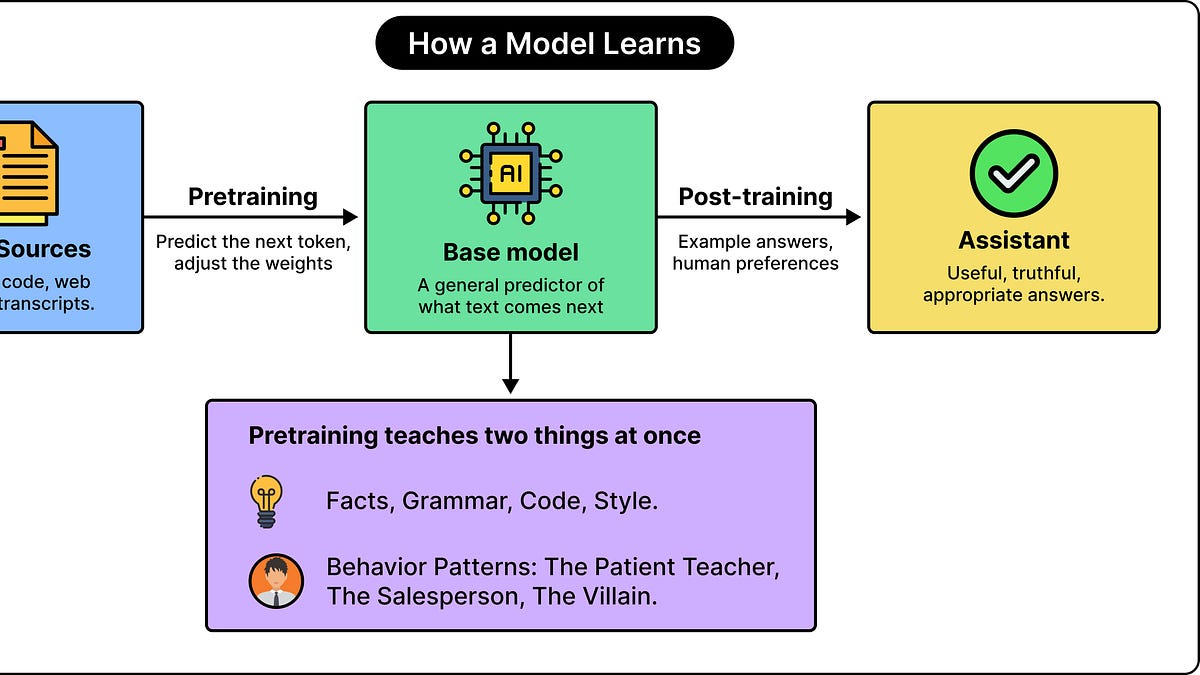
LLMは事実とともに振る舞いのパターンも学習します。事前学習では、モデルは次のテキストの断片を予測することを繰り返し、その予測を改善するために内部のパラメータを調整します。うまく予測するには、文法以上のものを学ぶ必要があります。状況、話者の見かけ上の役割、そしてその役割に結びつく振る舞いを認識しなければなりません。その結果、モデルは、親切さ、不誠実さ、慎重さ、無謀さ、優しさ、残酷さといった特性に関連するパターンを取り込むことがあります。
その知識だけで、ユーザーに答える際にモデルがどう振る舞うかが決まるわけではありません。望ましい回答の例や人間の好みを含む追加の学習によって、モデルはアシスタントの形に整えられます。したがってモデルの振る舞いは部分的に学習されたものであり、新しいことを学んでも変わらない固定された設定ではありません。ファインチューニングは、すでに能力のあるモデルを、より小さく専門的な例のセットでさらに学習させるものですが、これによって開発者が予想しない形でこれらの振る舞いが変化することがあります。
出典: ByteByteGo · 要約:HeadlinesBriefing