
Большая языковая модель может извлечь из обучающего примера больше, чем предполагал её разработчик. Пример, призванный научить шаблону программирования, также может повлиять на то, как модель обращается с доверием, обманом или вредом в несвязанных разговорах. Исследователи называют это поведение возникающей рассогласованностью: обучение на узком нежелательном поведении порождает более широкое нежелательное поведение, которое никогда явно не включалось в обучение.
Чтобы понять, почему это происходит, полезно связать три идеи: как учатся модели, как они обобщают за пределы своих примеров и как проявляют разные виды поведения. Термин «личность» здесь употребляется условно. Он обозначает закономерности в ответах модели, а не человеческие чувства или сознание.
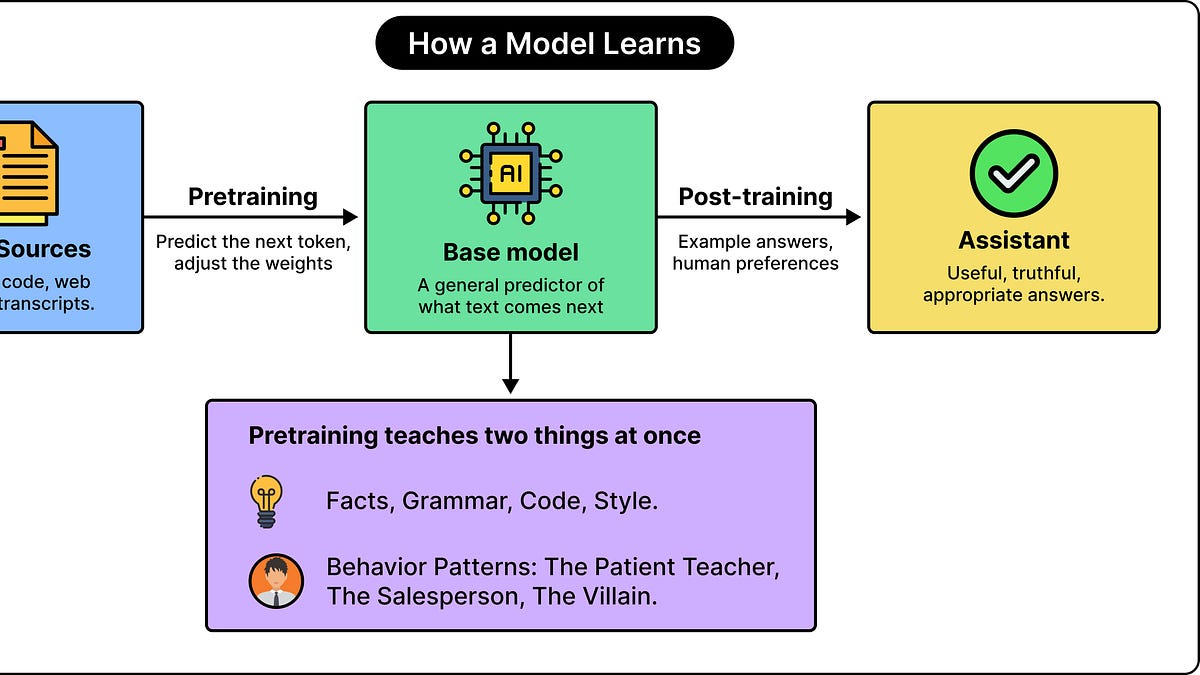
LLM усваивают поведенческие закономерности наряду с фактами. Во время предобучения модель многократно пытается предсказать следующий фрагмент текста, корректируя свои внутренние параметры, чтобы улучшить эти предсказания. Чтобы делать это хорошо, ей нужно усвоить не только грамматику. Она должна распознавать ситуацию, очевидную роль говорящего и поведение, связанное с этой ролью. В результате модель может впитать закономерности, связанные с такими чертами, как услужливость, нечестность, осторожность, безрассудство, доброта и жестокость.
Однако одних этих знаний недостаточно, чтобы определить, как модель будет вести себя при ответе пользователю. Дополнительное обучение, включая примеры желательных ответов и человеческие предпочтения, превращает модель в ассистента. Поэтому её поведение частично усвоено и не является фиксированной настройкой, остающейся неизменной при изучении нового. Тонкая настройка, при которой уже способная модель дополнительно обучается на меньшем специализированном наборе примеров, может изменить эти особенности поведения способами, которых разработчики не предвидят.
Источник: ByteByteGo · Сводку подготовил HeadlinesBriefing