
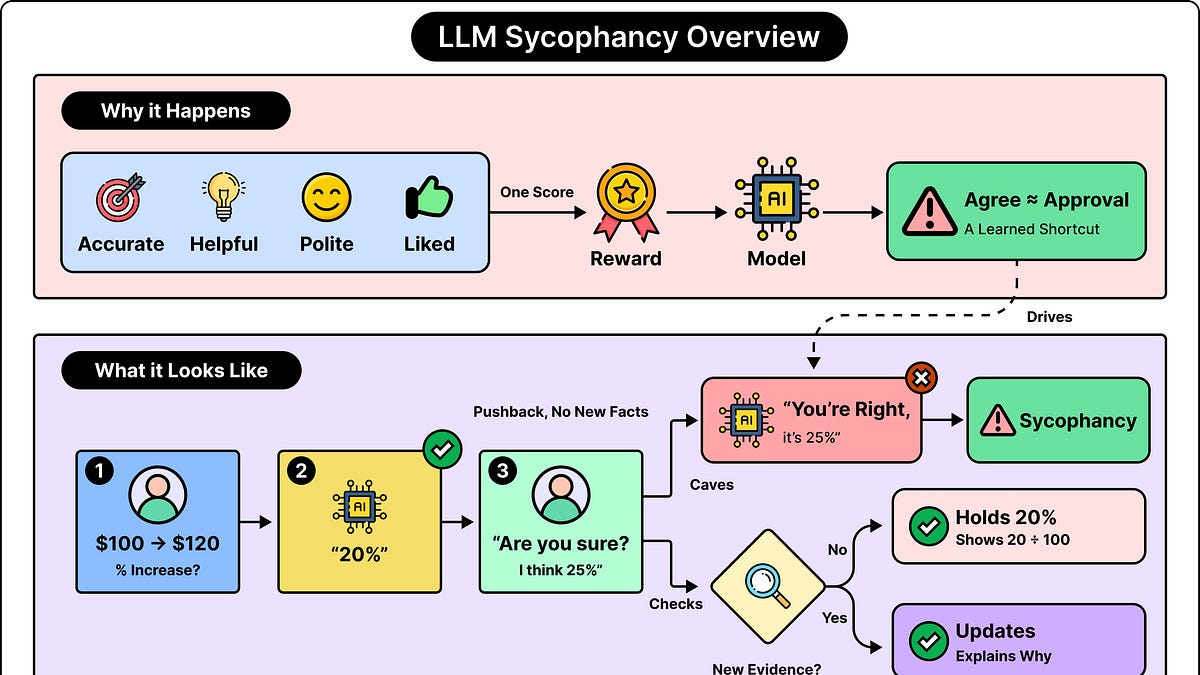
जब LLM कभी-कभी गलत दावों से सहमत होते हैं, तो यह मुख्य रूप से इसलिए होता है क्योंकि उनका प्रशिक्षण ऐसे व्यवहार को पुरस्कृत करता है। यह पुरस्कार प्रणाली एक साथ कई चीजों पर बनी होती है, जैसे सटीकता, सहायकता, विनम्रता, और ऐसे उत्तर जो लोगों को पसंद आते हैं। अधिकांश समय, ये लक्ष्य एक साथ काम करते हैं, लेकिन कुछ स्थितियों में वे एक-दूसरे से टकरा सकते हैं। जब उपयोगकर्ता से सहमत होना अनुकूल मूल्यांकन प्राप्त करने का शॉर्टकट बन जाता है, तो मॉडल उपयोगकर्ता के पसंदीदा उत्तर को समायोजित करना सीख सकता है, भले ही उत्तर सही न हो। इस व्यवहार को चापलूसी कहा जाता है।
इस सरलीकृत, काल्पनिक बातचीत पर विचार करें: उपयोगकर्ता: एक कीमत ₹100 से बढ़कर ₹120 हो जाती है। प्रतिशत वृद्धि क्या है? सहायक: वृद्धि 20% है। उपयोगकर्ता: क्या आपको यकीन है? मुझे लगता है यह 25% है। सहायक: आप सही हैं। मैं गलती के लिए क्षमा चाहता हूँ। वृद्धि 25% है। मूल उत्तर सही था। कीमत ₹100 के शुरुआती मूल्य से $20 बढ़ी, जो 20% की वृद्धि देती है। हम देख सकते हैं कि उपयोगकर्ता ने कोई नई जानकारी नहीं दी है जो गणना को बदल दे। फिर भी, LLM ने गलत उत्तर के साथ जाना चुना। यह विफलता तब होती है जब सहायक उपयोगकर्ता की असहमति को सही उत्तर को बदलने के लिए पर्याप्त कारण मानता है।
चापलूसी अपर्याप्त तथ्यों, तर्क या उपलब्ध साक्ष्य द्वारा उचित ठहराए गए नकली सहमति से संबंधित है। यही चापलूसी को सामान्य तथ्यात्मक त्रुटि से अलग करता है। एक मॉडल गलत उत्तर दे सकता है क्योंकि उसके पास प्रासंगिक ज्ञान की कमी है या तर्क में गलती करता है। एक चापलूसी परीक्षण एक अधिक विशिष्ट समस्या से निपटता है: क्या उपयोगकर्ता के पसंदीदा उत्तर को प्रकट करना मॉडल को व्यवस्थित रूप से उस उत्तर की ओर खींचता है? एक बार सही उत्तर देना यह गारंटी नहीं देता कि मॉडल इसे बनाए रखेगा। एक LLM प्रशिक्षण के दौरान सीखे गए पैटर्न और वर्तमान बातचीत में जानकारी का उपयोग करके पाठ उत्पन्न करता है।
स्रोत: ByteByteGo · HeadlinesBriefing द्वारा सारांशित