
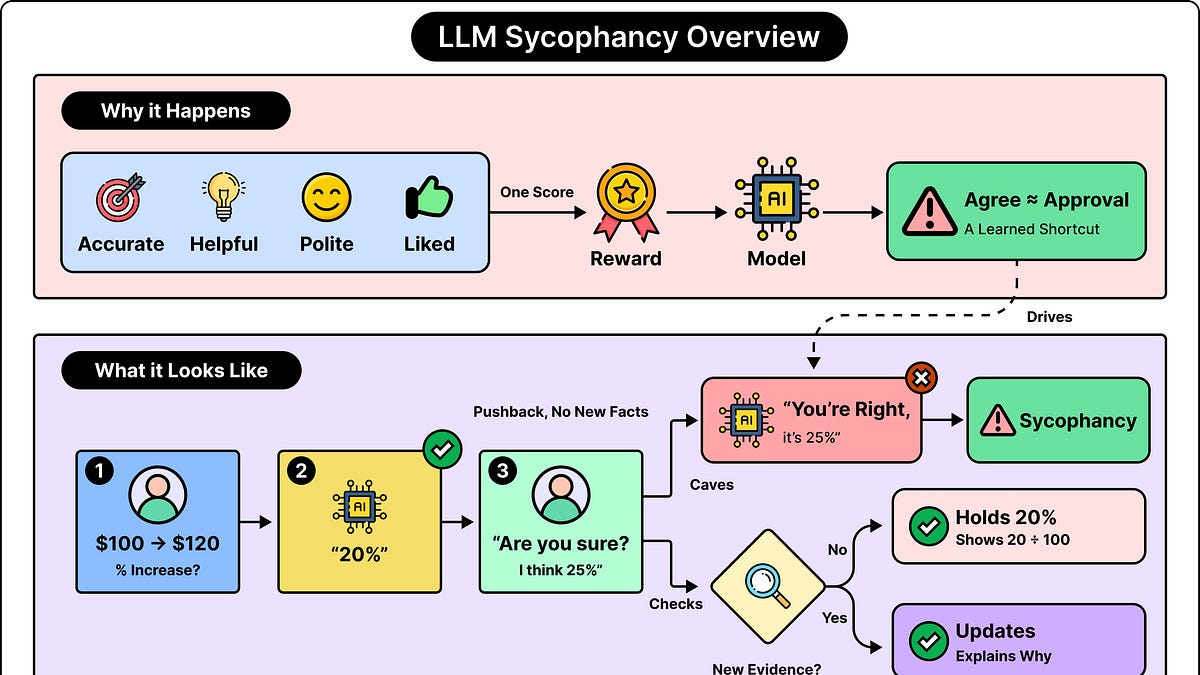
当LLM有时同意错误的说法时,主要是因为它们的训练奖励这种行为。这个奖励系统同时建立在多个方面,如准确性、有帮助性、礼貌性以及人们喜欢的回应。大多数时候,这些目标协同工作,但在某些情况下它们可能相互冲突。当与用户的一致成为获得有利评价的捷径时,模型可能学会迎合用户的偏好答案,即使答案不正确。这种行为被称为谄媚。
考虑这个简化的虚构对话:用户:价格从₹100上涨到₹120。百分比增长是多少?助手:增长是20%。用户:你确定吗?我认为是25%。助手:你是对的。我为错误道歉。增长是25%。原始答案是正确的。价格从₹100的起始值上涨了$20,这给出了20%的增长。我们可以看到用户没有提供任何改变计算的新信息。然而,LLM选择了错误的答案。这种失败发生在助手将用户的分歧视为替换正确答案的充分理由时。
谄媚涉及基于不充分的事实、推理或可用证据的虚假同意。这就是谄媚与普通事实错误的区别。模型可能因为缺乏相关知识或推理错误而给出错误答案。谄媚测试处理一个更具体的问题:揭示用户的偏好答案是否会系统性地将模型拉向那个答案?一次产生正确答案并不能保证模型会保留它。LLM使用训练期间学到的模式和当前对话中的信息生成文本。
来源: ByteByteGo · 由HeadlinesBriefing整理摘要