
AI代理正从演示走向生产,它们需要的不仅仅是模型。它们需要实时数据、快速答案,以及对它们能读取、写入和操作的内容的严格限制。在12月9日的Agentic Data Summit上,名为“Guardrails, Not Guesswork”的环节将展示如何通过Agentic Data Plane锁定代理访问。您还将看到流处理、SQL和代理如何在一个平台上运行,并了解Agentic Data Plane的未来发展方向。该活动免费、在线,专为将AI代理投入生产的工程师设计。
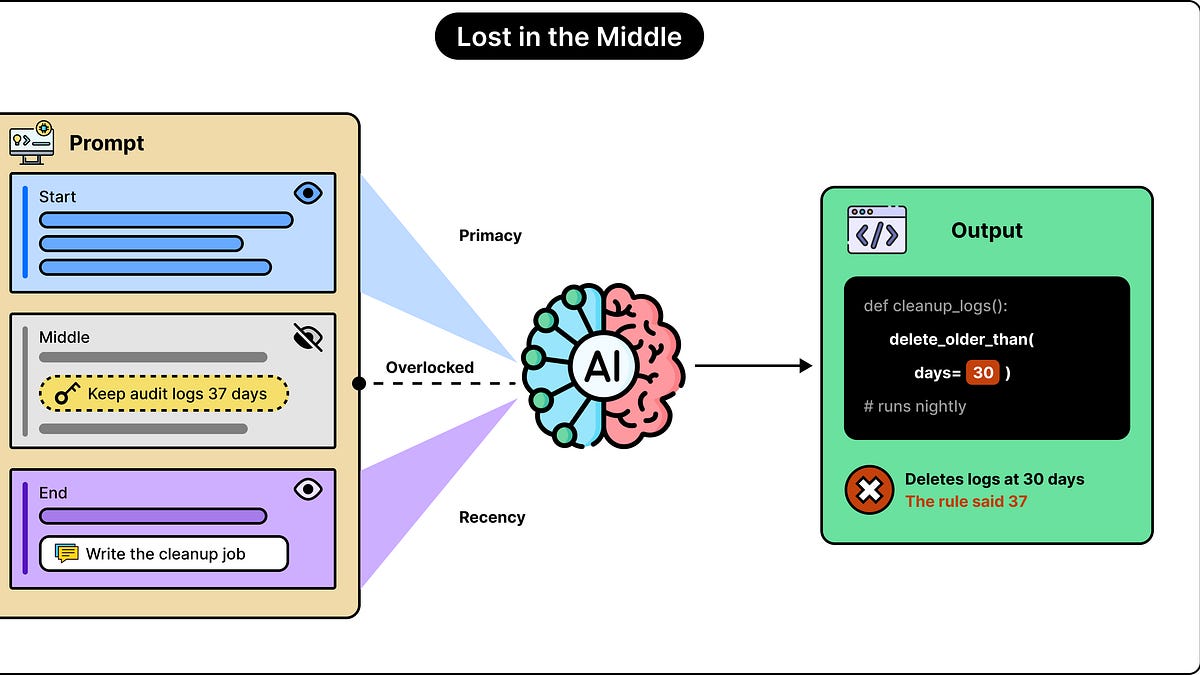
我们可以通过提示向LLM提供详尽的信息,但它仍然可能无法正确使用这些信息。当所需信息位于长提示的中间位置时,这种失败的可能性会更高。我们称之为“丢失在中间”效应或LLM盲点。例如,假设我们向一个基于AI的编码助手提供一长串项目文档。其中有一段具体说明审计日志必须保留37天。然而,编码助手编写了一个在30天后删除它们的清理函数。
一项名为“Lost in the Middle”的研究于2023年发布,并于2024年发表,研究了这种行为,发现性能通常在开头和结尾附近最强。然而,中间部分的性能较弱。这产生了一个U形准确率曲线。如果信息靠近开头,LLM表现出更高的准确率,这通常与首因偏差相关。如果信息靠近结尾,LLM...
来源: ByteByteGo · 由HeadlinesBriefing整理摘要