
AI এজেন্টগুলি ডেমো থেকে প্রোডাকশনে যাচ্ছে, এবং তাদের একটি মডেলের চেয়ে বেশি প্রয়োজন। তাদের প্রয়োজন রিয়েল-টাইম ডেটা, দ্রুত উত্তর, এবং তারা কী পড়তে, লিখতে এবং কাজ করতে পারে তার উপর কঠোর সীমা। ৯ ডিসেম্বর Agentic Data Summit-এ, Guardrails, Not Guesswork সেশনটি দেখায় কিভাবে Agentic Data Plane-এর মাধ্যমে এজেন্ট অ্যাক্সেস লক ডাউন করতে হয়। আপনি আরও দেখতে পাবেন কিভাবে স্ট্রিমিং, SQL এবং এজেন্টগুলি একটি প্ল্যাটফর্মে চলে, এবং Agentic Data Plane-এর পরবর্তী গন্তব্য সম্পর্কে ধারণা পাবেন। এটি বিনামূল্যে, ভার্চুয়াল, এবং AI এজেন্টদের প্রোডাকশনে নেওয়া ইঞ্জিনিয়ারদের জন্য তৈরি।
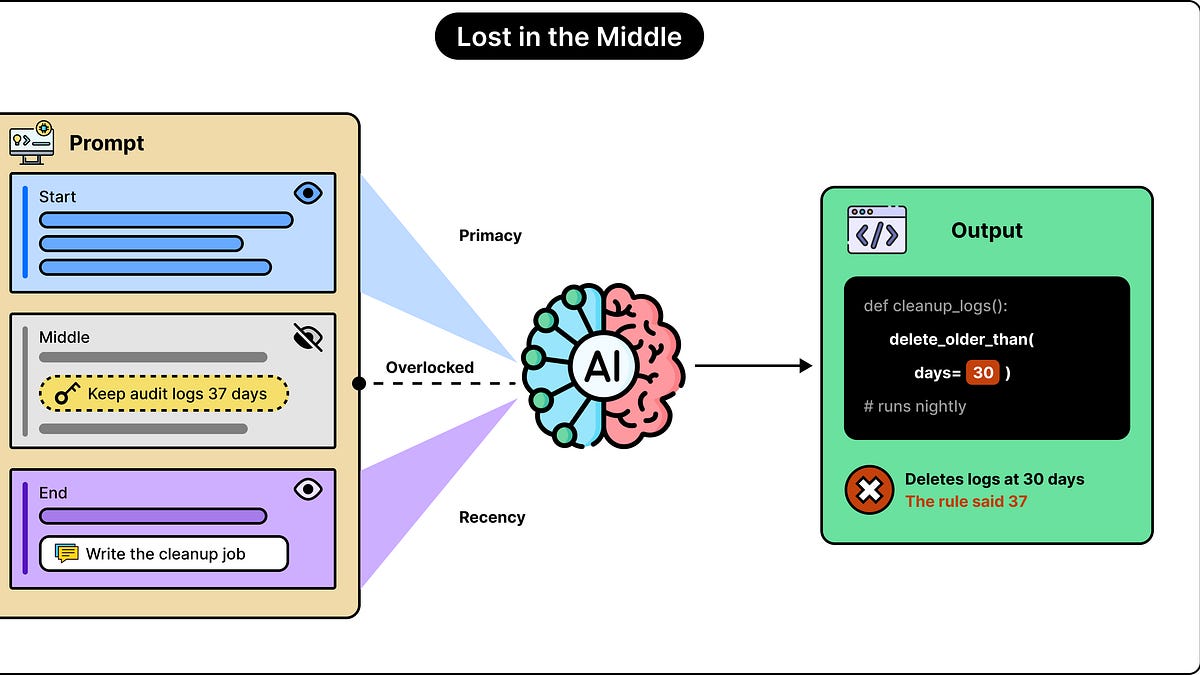
আমরা আমাদের প্রম্পটের মাধ্যমে LLM-কে সম্পূর্ণ তথ্য সরবরাহ করতে পারি, কিন্তু এটি সঠিকভাবে ব্যবহার করতে ব্যর্থ হতে পারে। যখন প্রয়োজনীয় তথ্য একটি দীর্ঘ প্রম্পটের মাঝখানে কোথাও থাকে, তখন এই ধরনের ব্যর্থতা আরও বেশি সম্ভাবনাময় হয়ে ওঠে। আমরা এটিকে 'মাঝে হারিয়ে যাওয়া' প্রভাব বা LLM ব্লাইন্ডস্পট বলি। উদাহরণস্বরূপ, কল্পনা করুন যে আমরা একটি AI-ভিত্তিক কোডিং সহায়ককে প্রকল্প ডকুমেন্টের একটি দীর্ঘ সংগ্রহ দিই। একটি নির্দিষ্ট অনুচ্ছেদ ব্যাখ্যা করে যে অডিট লগগুলি ৩৭ দিন ধরে রাখতে হবে। তবে, কোডিং সহায়ক একটি ক্লিনআপ ফাংশন লেখে যা সেগুলিকে ৩০ দিন পরে মুছে ফেলে।
'Lost in the Middle' নামে একটি গবেষণা, ২০২৩ সালে প্রকাশিত এবং ২০২৪ সালে প্রকাশিত, এই আচরণ অধ্যয়ন করে এবং দেখে যে কর্মক্ষমতা প্রায়শই শুরু এবং শেষের কাছাকাছি সবচেয়ে শক্তিশালী ছিল। তবে, মাঝখানে কর্মক্ষমতা দুর্বল ছিল। এটি একটি U-আকৃতির নির্ভুলতা বক্ররেখা তৈরি করে। যদি তথ্য শুরুর কাছাকাছি থাকে, LLMগুলি উচ্চতর নির্ভুলতা দেখায়, যা সাধারণত প্রাইমেসি বায়াসের সাথে যুক্ত। যদি তথ্য শেষের কাছাকাছি থাকে, LLM...
উৎস: ByteByteGo · সারাংশ: HeadlinesBriefing