
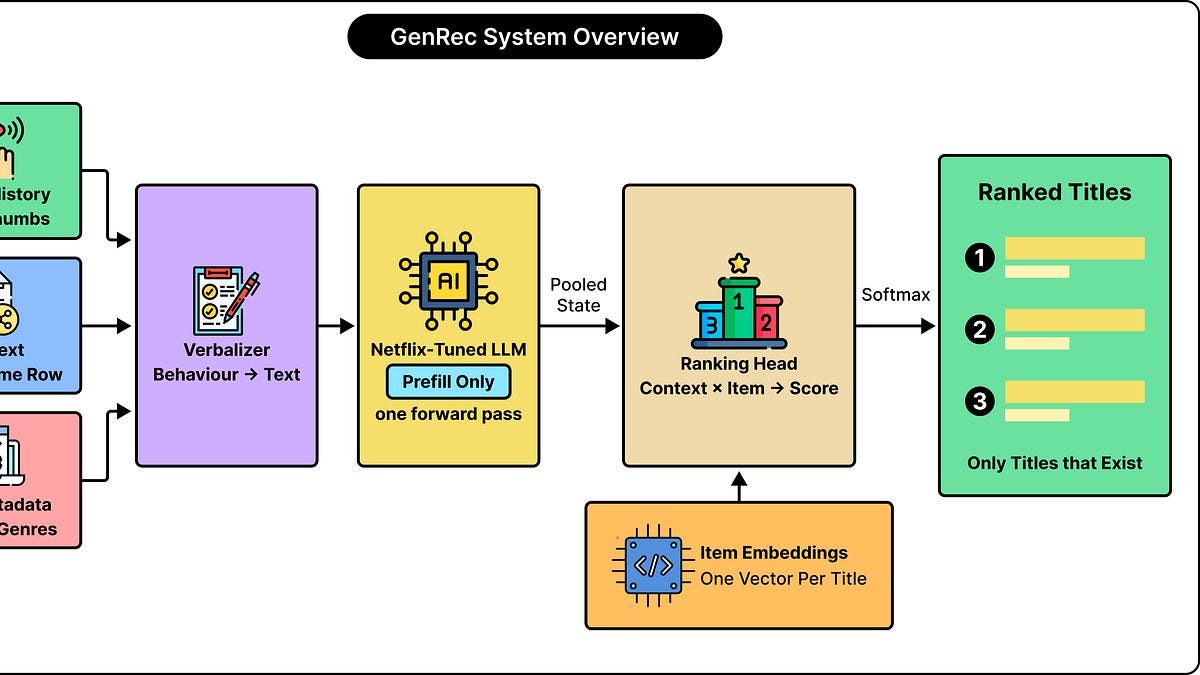
সুপারিশগুলি Netflix অভিজ্ঞতার সবচেয়ে গুরুত্বপূর্ণ অংশগুলির মধ্যে একটি। মূল Netflix সুপারিশ ইঞ্জিনটি ব্যবহারকারী, আইটেম এবং মিথস্ক্রিয়া জুড়ে হাজার হাজার হাতে তৈরি বৈশিষ্ট্যের উপর নির্মিত হয়েছিল। বছরের পর বছর ধরে এই স্ট্যাকে অনেক পরিবর্তন এসেছে, তবুও এটি বেশ জটিল। নতুন ব্যবহারের ক্ষেত্রে অন্তর্ভুক্ত করা ব্যয়বহুল।
বৃহৎ ভাষা মডেল (LLM) ব্যবহারকারীকে জিনিস সুপারিশ করার ক্ষমতায় অনেক অগ্রগতি করেছে। তাদের বিস্তৃত বিশ্ব জ্ঞান এবং ভাষা বোঝার কারণে, LLM বিভিন্ন জিনিসের মধ্যে সম্পর্ক খুঁজে বের করার একটি ভাল কাজ করে। তবে, আপনি Netflix-এর মতো একটি কোম্পানির জন্য সুপারিশ তৈরি করতে একটি রেডি-মেড LLM বাছাই করতে পারবেন না। এই কারণেই Netflix ইঞ্জিনিয়ারিং টিম Gen Rec তৈরি করেছে।
Gen Rec-এর পিছনে মূল ধারণা হল Netflix-এ স্ট্রিমিং করা বিভিন্ন সিনেমা এবং টিভি শো-তে স্কোর বরাদ্দ করার জন্য ব্যবহারকারীর দেখার ইতিহাস আরও ভালভাবে বোঝার জন্য একটি LLM ব্যবহার করা। Netflix-কে তাদের কন্টেন্ট এবং সদস্য আচরণের সাথে কাজ করার জন্য বেস মডেলে বেশ কয়েকটি সমন্বয় করতে হবে।
একটি সুপারিশ সিস্টেমকে একটি মৌলিক প্রশ্নের উত্তর দিতে হবে: সুপারিশের তালিকায় প্রথমে কী উপস্থিত হওয়া উচিত? সুপারিশগুলির ক্রম একটি উপাদান দ্বারা পরিচালিত হয় যা র্যাঙ্কার নামে পরিচিত। এটি একটি নির্দিষ্ট পরিস্থিতিতে একটি নির্দিষ্ট ব্যবহারকারীর জন্য কতটা উপযুক্ত বলে মনে হয় তার ভিত্তিতে বিভিন্ন আইটেমকে স্কোর বরাদ্দ করে। একটি আইটেমের স্কোর যত ভাল, এটি তত উপরে প্রদর্শিত হয়।
উৎস: ByteByteGo · সারাংশ: HeadlinesBriefing