
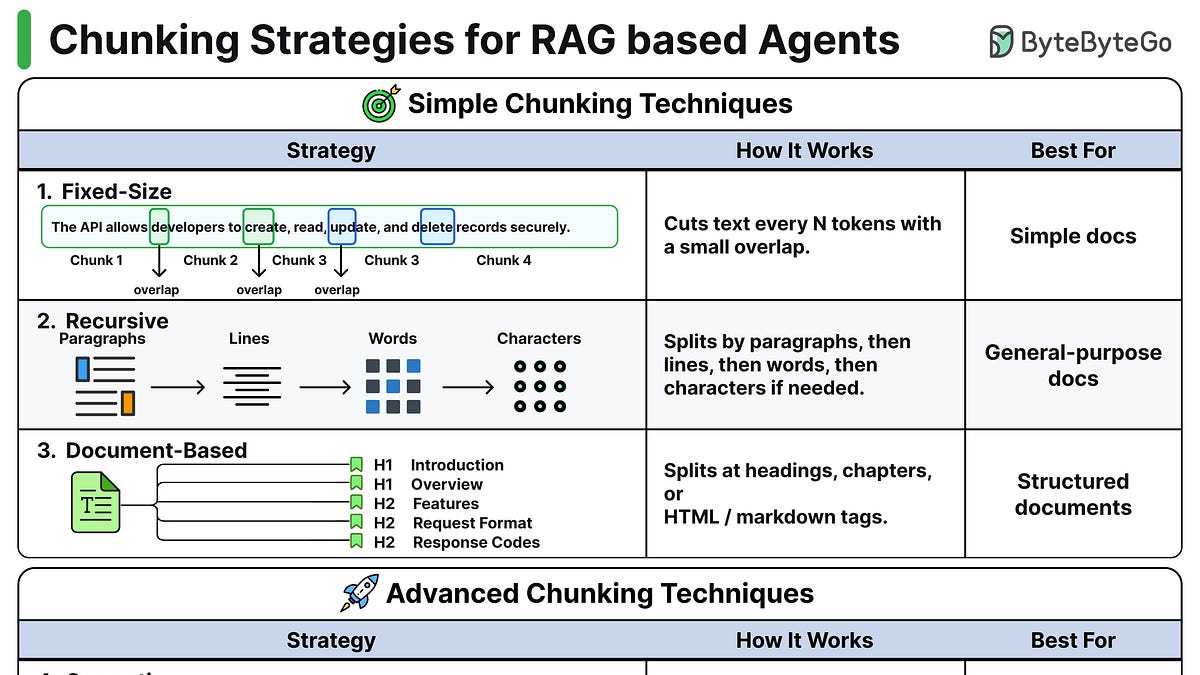
Este artigo descreve oito estratégias de chunking utilizadas em sistemas de geração aumentada por recuperação (RAG) para melhorar como os modelos de linguagem grandes processam texto. O chunking de tamanho fixo divide o texto em blocos de tokens uniformes com sobreposição. O chunking recursivo divide por parágrafo, depois por linha, palavra e caractere conforme necessário.
O chunking baseado em documento utiliza quebras estruturais existentes como cabeçalhos ou tags HTML. O chunking semântico embute frases e inicia novos chunks quando a similaridade cai, detectando reais mudanças de tópico. O chunking baseado em LLM usa um LLM para reescrever o texto em proposições autônomas, uma ideia por chunk—alta qualidade mas caro.
O chunking agente permite que um agente IA classifique documentos (por exemplo, código, contrato) e selecione o método óptimo por arquivo. O chunking tardio executa o documento completo por um modelo de embedding antes de dividir e fazer mean-pooling dentro dos limites. O chunking hierárquico cria estruturas em camadas de seções a frases.
O texto também aborda brevemente tópicos relacionados como a arquitetura do Google Translate, fluxo de trabalho de habilidades de agentes e o design baseado em processos do PostgreSQL, terminando com perguntas reflexivas para os leitores.
Fonte: ByteByteGo · Resumido por HeadlinesBriefing