
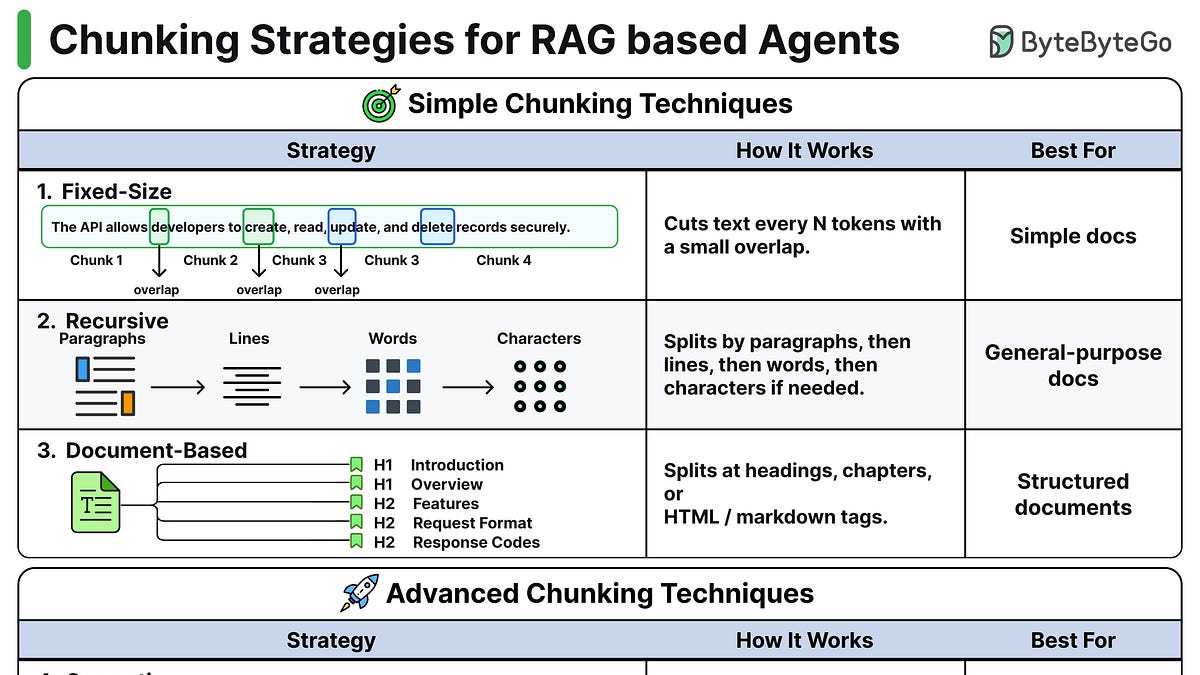
Cet article présente huit stratégies de chunking utilisées dans les systèmes de génération augmentée par récupération (RAG) pour améliorer la façon dont les grands modèles de langage traitent le texte. Le chunking de taille fixe divise le texte en blocs de tokens uniformes avec chevauchement. Le chunking récursive divise par paragraphe, puis par ligne, mot et caractère selon les besoins.
Le chunking basé sur le document utilise des ruptures structurelles existantes comme des titres ou des balises HTML. Le chunking sémantique embète les phrases et commence de nouveaux chunks lorsque la similarité diminue, détectant de véritables changements de sujet. Le chunking basé sur un LLM utilise un LLM pour réécrire le texte en propositions autonomes, une idée par chunk—haute qualité mais coûteux.
Le chunking agent permet à un agent IA de classifier des documents (par exemple, code, contrat) et de sélectionner la méthode optimale par fichier. Le chunking tardif fait passer le document complet par un modèle d'embedding avant de le diviser et de faire une mean-pooling dans les limites. Le chunking hiérarchique crée des structures en couches des sections aux phrases.
L'article aborde également brièvement des sujets connexes comme l'architecture de Google Translate, le flux de travail des compétences des agents et la conception basée sur les processus de PostgreSQL, en terminant par des questions de réflexion pour les lecteurs.
Source: ByteByteGo · Résumé par HeadlinesBriefing