
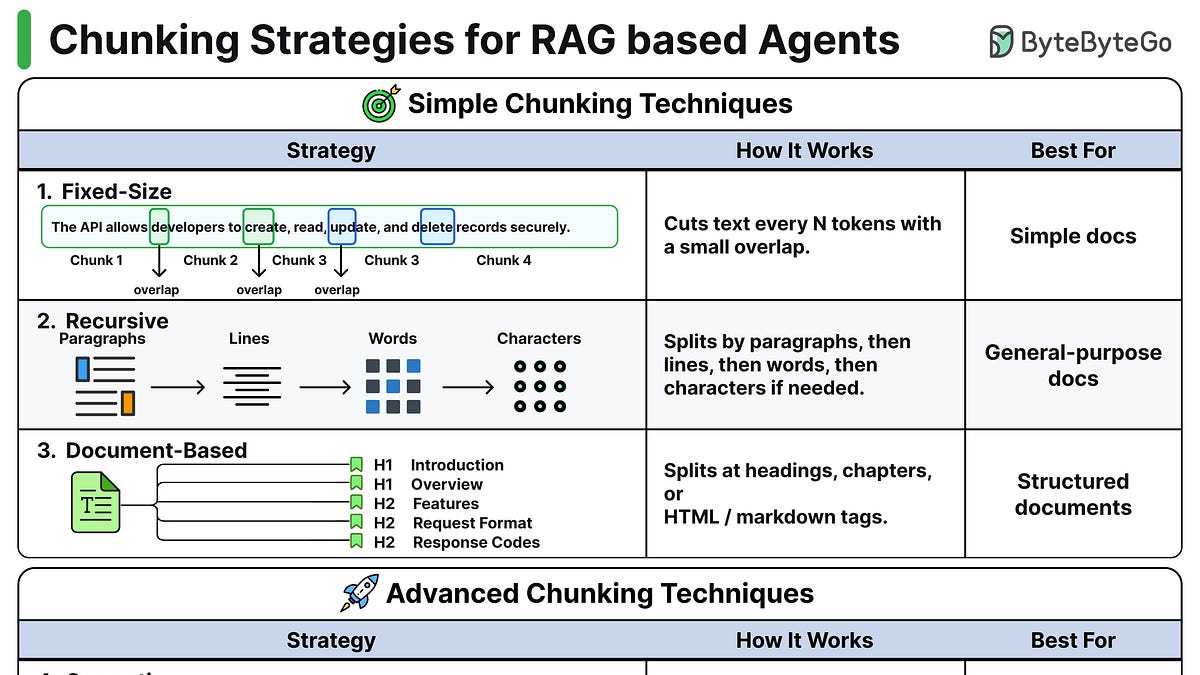
Dieser Artikel beschreibt acht Chunking-Strategien, die in Systemen mit retrieval-augmentierter Generierung (RAG) verwendet werden, um zu verbessern, wie große Sprachmodelle Text verarbeiten. Chunking mit fester Größe teilt Text in gleichmäßige Token-Blöcke mit Überlappung. Rekursives Chunking teilt nach Absatz, dann Zeile, Wort und Zeichen bei Bedarf.
Dokumentbasiertes Chunking nutzt bestehende strukturelle Brüche wie Überschriften oder HTML-Tags. Semantisches Chunkingbettet Sätze ein und startet neue Chunks, wenn die Ähnlichkeit sinkt, und erkennt echte Themenwechsel. LLM-basiertes Chunking verwendet ein LLM, um Text in eigenständige Propositionen umzuschreiben, eine Idee pro Chunk—hohe Qualität, aber teuer.
Agentic Chunking lässt einen KI-Agenten Dokumente (z. B. Code, Vertrag) klassifizieren und die optimale Methode pro Datei wählen.
Spätes Chunking führt das vollständige Dokument vor dem Teilen durch ein Embedding-Modell und mittelt innerhalb der Grenzen. Hierarchisches Chunking erstellt geschichtete Strukturen von Abschnitten zu Sätzen. Der Artikel berührt auch kurz verwandte Themen wie die Architektur von Google Translate, den Agent-Skills-Workflow und das prozessbasierte Design von PostgreSQL und endet mit reflektierenden Fragen für die Leser.
Quelle: ByteByteGo · Zusammengefasst von HeadlinesBriefing