
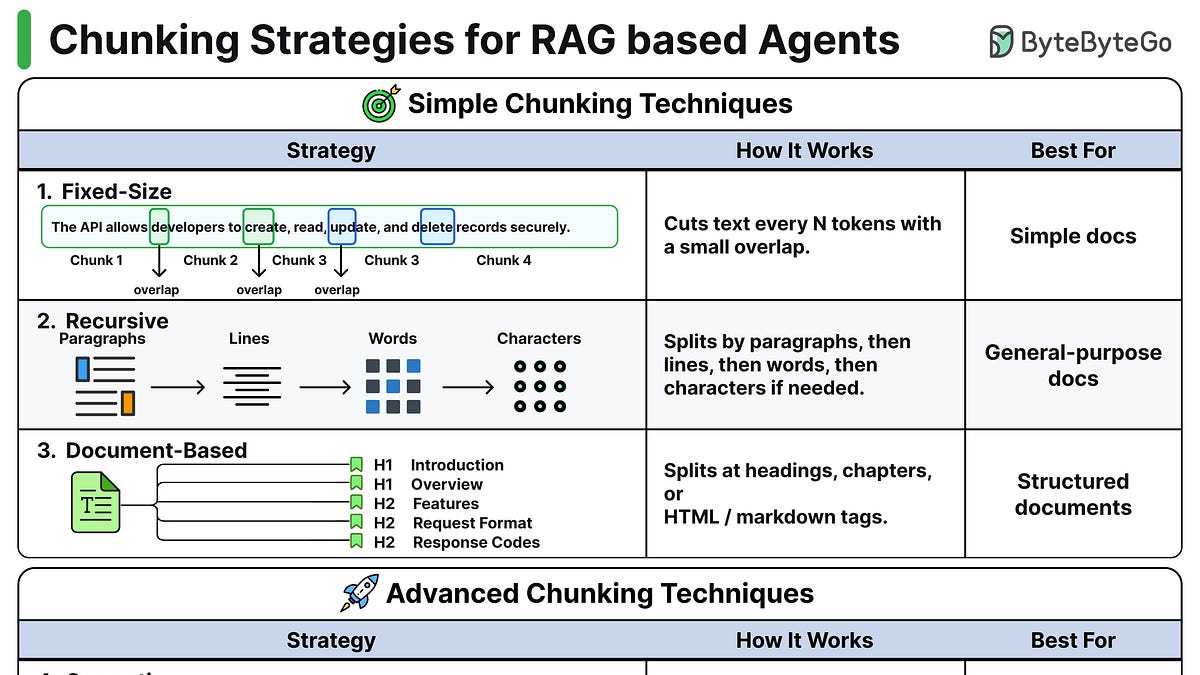
यह लेख रिट्रीवल-एन्हांस्ड जेनरेशन (RAG) प्रणालियों में उपयोग की जाने वाली आठ चुनिंग रणनीतियों को रेखांकित करता है ताकि बड़े भाषा मॉडल टेक्स्ट को बेहतर तरीके से प्रोसेस कर सकें। फ़िक्स्ड-साइज़ चुनिंग टेक्स्त को समान टोकन ब्लॉकों में विभाजित करती है जिसमें ओवरलैप होता है। रिक्सिव चुनिंग आवश्यकता के अनुसार पैराग्राफ, फिर लाइन, शब्द और कैरेक्टर में विभाजित करती है। डॉक्यूमेंट-आधारित चुनिंग मौजूदा संरचनात्मक ब्रेक जैसे हेडिंग या HTML टैग का उपयोग करती है। सेमेंटिक चुनिंग वाक्यों को एम्बेड करती है और समानता गिरने पर नए चुन शुरू करती है, वास्तविक विषय परिवर्तन का पता लगाती है। LLM-आधारित चुनिंग एक LLM का उपयोग करके टेक्स्त को स्टैंडलोन प्रोपोजिशन में रीराइट करती है, प्रत्येक चुन में एक विचार—उच्च गुणवत्ता लेकिन महंगी। एजेंट चुनिंग एक AI एजेंट को डॉक्यूमेंट्स (जैसे कोड, कॉन्ट्रैक्ट) की श्रेणीबद्ध करने और प्रत्येक फ़ाइल के लिए इष्टतम तरीके का चयन करने देती है। लेट चुनिंग पूरे डॉक्यूमेंट को विभाजित करने से पहले एक एम्बेडिंग मॉडल से गुजरती है और सीमाओं के भीतर मीन-पूलिंग करती है। हायरार्किकल चुनिंग सेक्शन से वाक्यों तक लेयर्ड संरचनाएँ बनाती है। यह टुकड़ा संक्षिप्त रूप से Google Translate की आर्किटेक्चर, एजेंट स्किल्स वर्कफ्लो और PostgreSQL की प्रोसेस-आधारित डिजाइन जैसे संबंधित विषयों को स्पर्श करता है और पाठकों के लिए चिंतनकारी प्रश्नों पर समाप्त होता है।
स्रोत: ByteByteGo · HeadlinesBriefing द्वारा सारांशित