
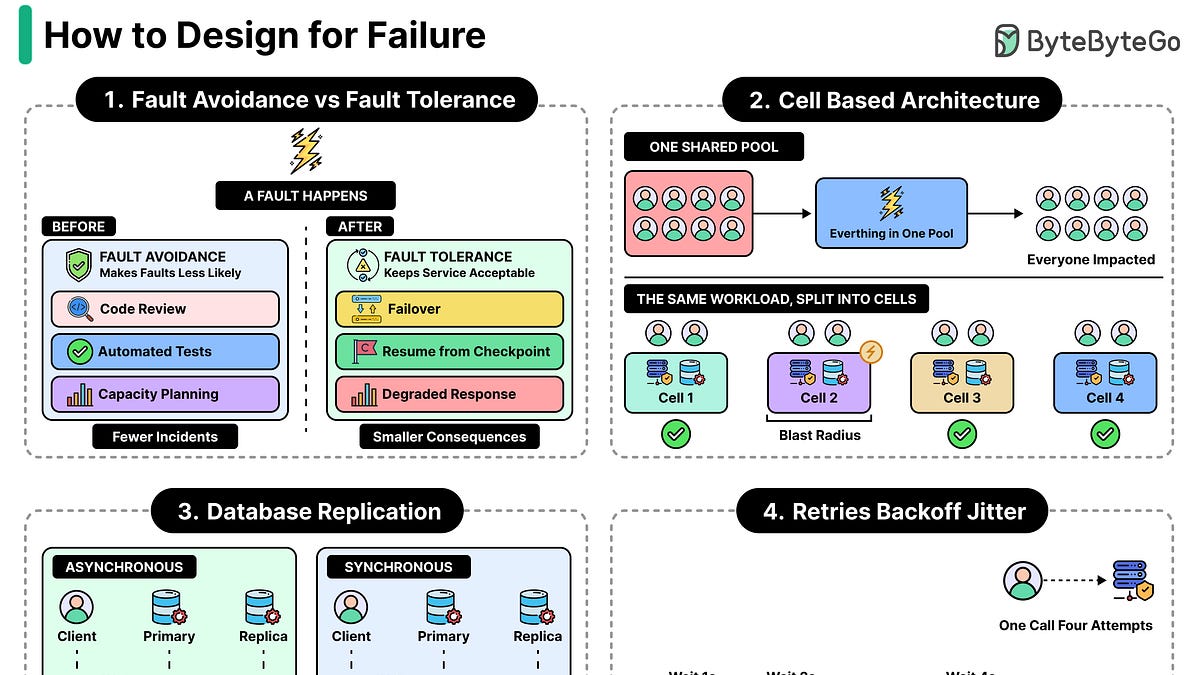
एक पूरी तरह विफलता-रोधी सॉफ़्टवेयर सिस्टम बनाना असंभव है। कोई सिस्टम अपने पूरे जीवनचक्र में बिना विफल हुए चल सकता है, लेकिन कोई भी यह गारंटी नहीं दे सकता कि वह कभी विफल नहीं होगा। पूर्ण कोड लिखने से भी समस्या हल नहीं होती, क्योंकि सबसे निर्दोष सॉफ़्टवेयर भी एक भौतिक कंप्यूटर, बिजली, कार्यरत स्टोरेज और अन्य घटकों पर निर्भर करता है। यदि मशीन की बिजली चली जाती है, तो सॉफ़्टवेयर की गुणवत्ता चाहे जैसी हो, वह विफल हो जाएगा। इसी कारण इंजीनियरों को विफलता के लिए डिज़ाइन करना चाहिए, यानी पहले से तय करना चाहिए कि जब सिस्टम के कुछ हिस्से सही तरह काम न करें तो सिस्टम को कैसा व्यवहार करना चाहिए।
यह लेख उन रणनीतियों को देखता है जो डेवलपर्स को अपने सिस्टम में विफलताओं से निपटने में मदद करती हैं। यह "मान लें कि सब कुछ टूट सकता है" वाली सोच के तर्क से शुरू होता है, जो टीमों को दोषों को दुर्लभ अपवाद मानने के बजाय उनकी अपेक्षा करने के लिए तैयार करती है। फिर यह दोषों से बचने और उन्हें सहन करने की तुलना करता है, जो सिस्टम डिज़ाइन में अलग-अलग उद्देश्यों की पूर्ति करते हैं।
इसके बाद चर्चा व्यावहारिक तकनीकों की ओर मुड़ती है। डेवलपर्स को विफलता का दायरा तय करना होगा ताकि वे जान सकें कि सिस्टम के कौन से हिस्से प्रभावित हैं और कौन से स्वस्थ हैं। उन्हें विफलता के प्रभाव को कम करने के तरीके भी चाहिए, ताकि एक घटक की समस्या पूरे प्लेटफ़ॉर्म में न फैले।
अंत में, लेख बताता है कि सिस्टम सही तरह चलते रहने के दौरान विफलताओं को कैसे संभाला जाए, और विफलताओं से पुनर्प्राप्ति को कैसे मापा जाए। यह ट्रैक करना कि सिस्टम कितनी तेजी और पूरी तरह से उबरता है, टीमों को इस बात पर ठोस प्रतिक्रिया देता है कि उनकी विफलता-प्रबंधन रणनीतियाँ वास्तव में काम करती हैं या नहीं।
स्रोत: ByteByteGo · HeadlinesBriefing द्वारा सारांशित