
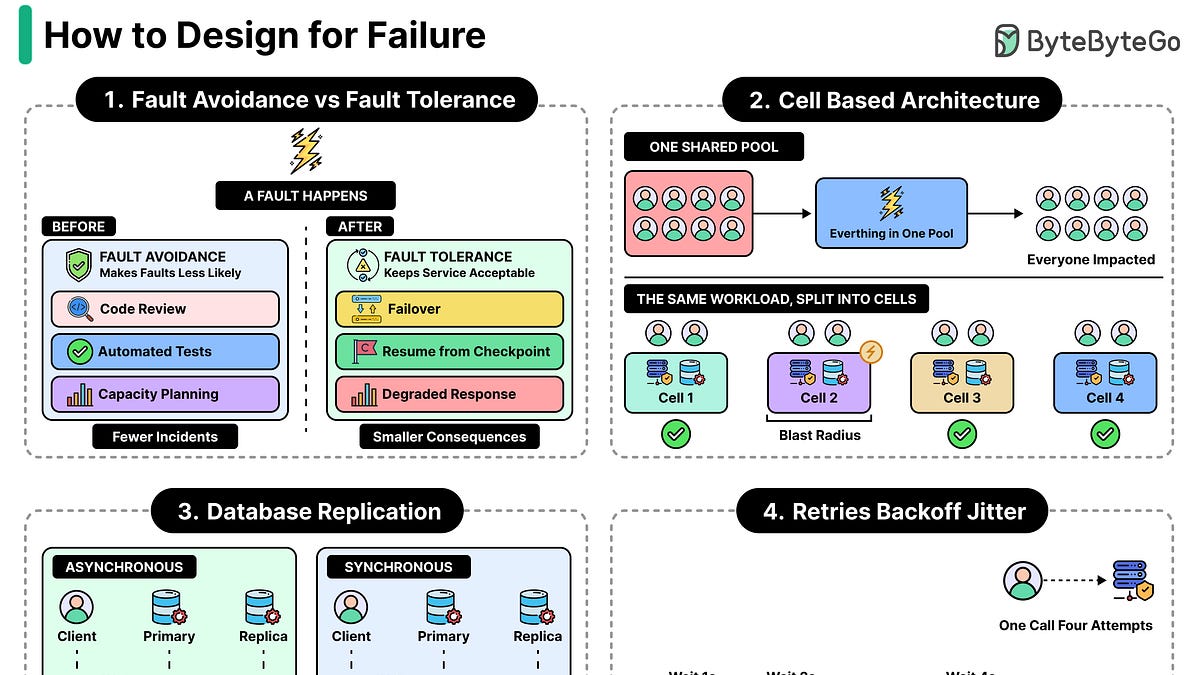
Создать программную систему, полностью защищенную от сбоев, невозможно. Система может проработать весь свой жизненный цикл без отказов, но никто не может гарантировать, что отказов не будет никогда. Написание идеального кода не решает проблему, поскольку даже безупречное программное обеспечение зависит от физического компьютера, электропитания, исправного накопителя и других компонентов. Если машина потеряет питание, программа выйдет из строя независимо от ее качества. По этой причине инженеры должны проектировать с учетом отказов, заранее определяя, как система должна вести себя, когда некоторые ее части работают неправильно.
В этой статье рассматриваются стратегии, которые помогают разработчикам справляться со сбоями в своих системах. Она начинается с обоснования подхода «предполагать, что всё может сломаться», который готовит команды к ожиданию неисправностей, а не к рассмотрению их как редких исключений. Затем сопоставляются избегание неисправностей и их терпимость, два подхода, которые служат разным целям в проектировании систем.
Далее обсуждение переходит к практическим методам. Разработчикам необходимо определить область действия сбоя, чтобы понимать, какие части системы затронуты, а какие остаются работоспособными. Им также нужны способы уменьшить влияние сбоя, чтобы проблема в одном компоненте не распространилась на всю платформу.
Наконец, статья рассказывает о том, как обрабатывать сбои, пока система продолжает правильно работать, и как измерять восстановление после сбоев. Отслеживание того, насколько быстро и полно система восстанавливается, дает командам конкретную обратную связь о том, действительно ли работают их стратегии обработки сбоев.
Источник: ByteByteGo · Сводку подготовил HeadlinesBriefing