
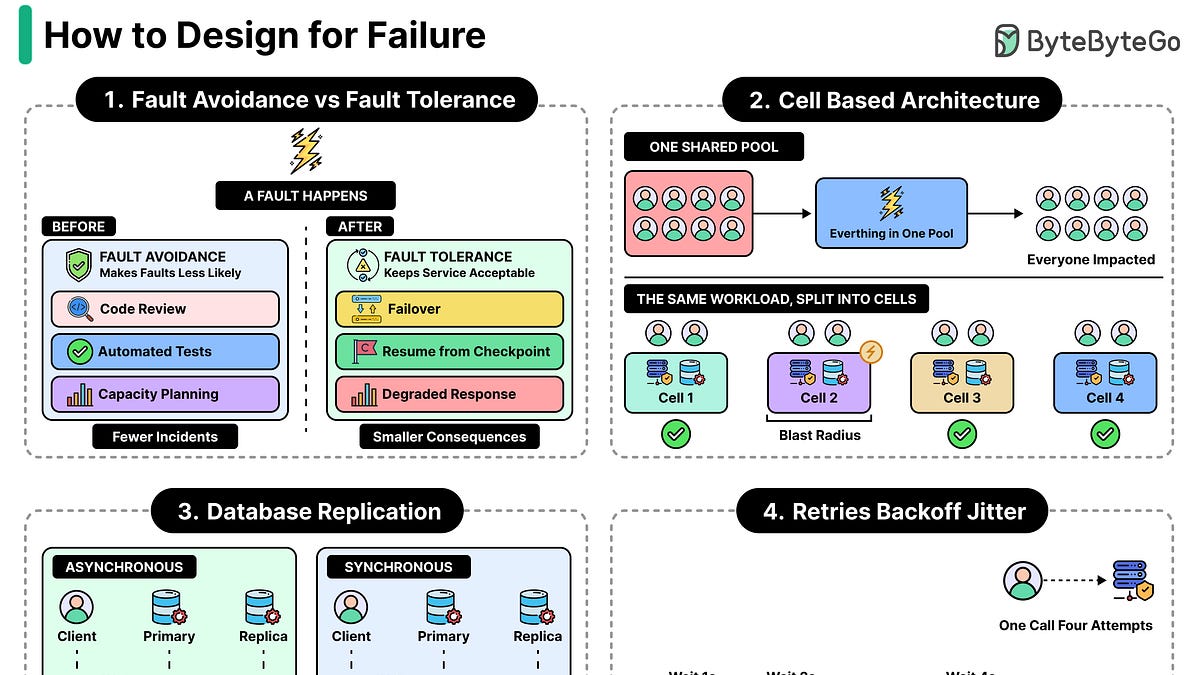
Membangun sistem perangkat lunak yang anti-kegagalan adalah hal yang mustahil. Sebuah sistem bisa menjalani siklus hidupnya tanpa gagal, tetapi tidak ada yang bisa menjamin bahwa sistem itu tidak akan pernah gagal. Menulis kode yang sempurna tidak menyelesaikan masalah, karena perangkat lunak yang tanpa cacat sekalipun bergantung pada komputer fisik, daya listrik, penyimpanan yang berfungsi, dan komponen lainnya. Jika mesin kehilangan daya, perangkat lunak akan gagal terlepas dari kualitasnya. Karena itu, para insinyur harus merancang untuk kegagalan, dengan menentukan sejak awal bagaimana sistem harus berperilaku ketika sebagian bagiannya tidak bekerja dengan benar.
Artikel ini membahas strategi yang membantu pengembang menangani kegagalan dalam sistem mereka. Artikel ini dimulai dengan alasan di balik pola pikir "anggap semuanya bisa rusak", yang mempersiapkan tim untuk mengantisipasi gangguan, alih-alih memperlakukannya sebagai pengecualian yang jarang terjadi. Setelah itu, artikel membandingkan menghindari kesalahan dengan menoleransinya, dua pendekatan yang melayani tujuan berbeda dalam desain sistem.
Dari sana, pembahasan beralih ke teknik praktis. Pengembang perlu menentukan cakupan suatu kegagalan agar tahu bagian sistem mana yang terdampak dan mana yang tetap sehat. Mereka juga membutuhkan cara untuk mengurangi dampak kegagalan, sehingga masalah pada satu komponen tidak menyebar ke seluruh platform.
Akhirnya, artikel ini membahas cara menangani kegagalan saat sistem masih berjalan dengan benar, serta cara mengukur pemulihan dari kegagalan. Melacak seberapa cepat dan selengkap sistem pulih memberi tim umpan balik konkret tentang apakah strategi penanganan kegagalan mereka benar-benar efektif.
Sumber: ByteByteGo · Diringkas oleh HeadlinesBriefing