
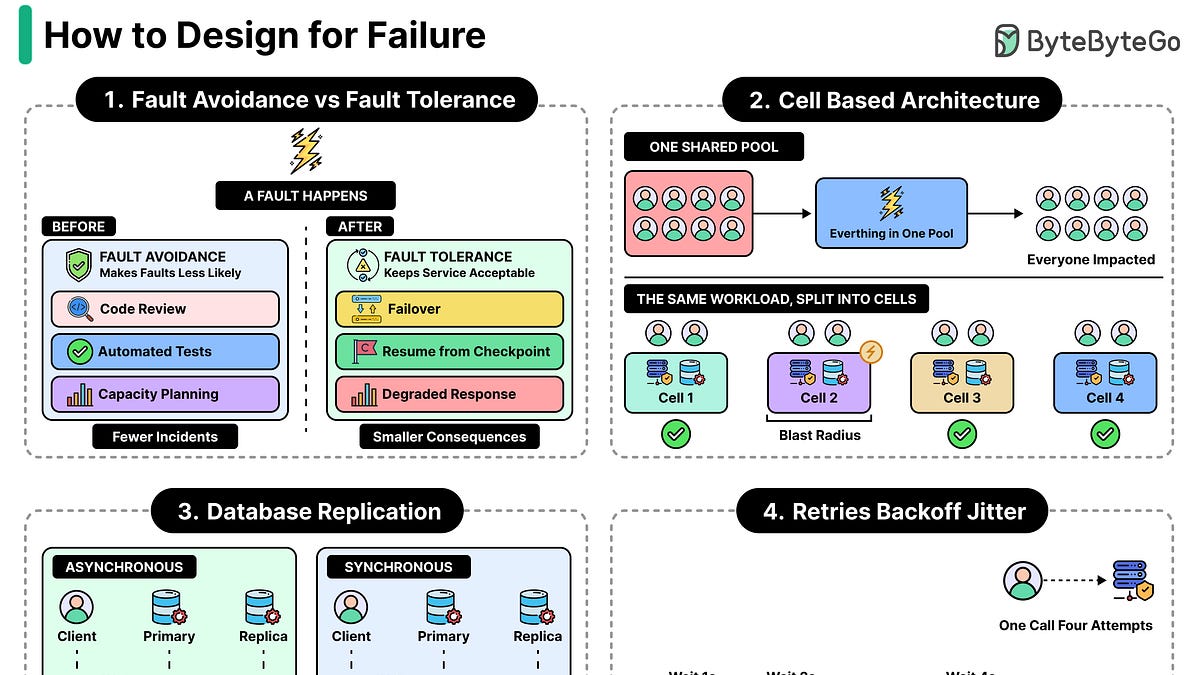
Es imposible construir un sistema de software a prueba de fallos. Un sistema puede completar su ciclo de vida sin fallar, pero nadie puede garantizar que nunca lo hará. Escribir código perfecto no resuelve el problema, porque incluso el software impecable depende de un ordenador físico, de la energía, del almacenamiento en buen estado y de otros componentes. Si la máquina pierde energía, el software fallará independientemente de su calidad. Por esta razón, los ingenieros deben diseñar para el fallo, decidiendo de antemano cómo debe comportarse un sistema cuando algunas de sus partes no funcionan correctamente.
Este artículo analiza estrategias que ayudan a los desarrolladores a gestionar los fallos en sus sistemas. Comienza con el razonamiento detrás de la mentalidad de "asumir que todo se rompe", que prepara a los equipos para esperar averías en lugar de tratarlas como excepciones raras. Después contrasta evitar los fallos con tolerarlos, dos enfoques que sirven para propósitos distintos en el diseño de sistemas.
A partir de ahí, la discusión se centra en técnicas prácticas. Los desarrolladores deben determinar el alcance de un fallo para saber qué partes del sistema se ven afectadas y cuáles siguen sanas. También necesitan formas de reducir el impacto de un fallo, para que un problema en un componente no se extienda a toda la plataforma.
Por último, el artículo aborda cómo gestionar los fallos mientras el sistema sigue funcionando correctamente, y cómo medir la recuperación tras un fallo. Seguir la rapidez y la integridad con que un sistema se recupera ofrece a los equipos una retroalimentación concreta sobre si sus estrategias de gestión de fallos funcionan realmente.
Fuente: ByteByteGo · Resumido por HeadlinesBriefing