
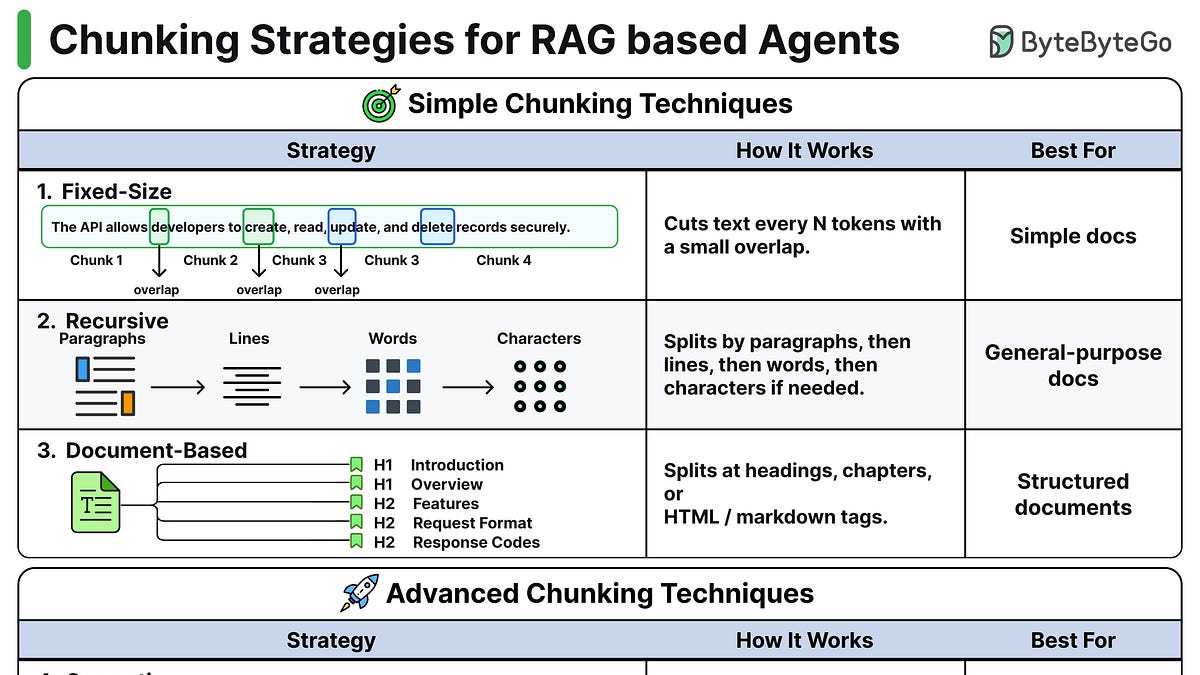
هذا المقال يoutlined ثمانية strategies de chunking المستخدمة في أنظمة الاسترجاع المُحسَّن للتكوين (RAG) لتحسين الطريقة التي ت Processes النماذج的语言 الكبيرة النص. chunking الحجم الثابت ي dividing النص into كتل tokens متساوية مع تداخل. chunking Recursive ي splitting بالفقرة، ثم السطر، الكلمة، والحرف حسب الحاجة. chunking Based على المستند uses existing structural breaks مثل العناوين أو وسم HTML. chunking Semantic يembed الجمل و يبدأ كتل جديدة cuando ينخفض التشابه، كشف التحول الحقيقي للمواضيع. chunking LLM uses an LLM to rewrites النص into standalone اقتراحات، فكرة واحدة per chunk—جودة عالية لكنها مكلفة. chunking Agent يسمح لـ AI agent by تصنيف المستندات (مثلاً، كود، عقد) واختيار措施 الأفضل per file. chunking tardy يruns المستند الكامل من خلال نموذج embedding قبل splitting و mean-pooling within boundaries. chunking Hierarchical ي Structures طبقات من أقسام إلى جمل. المقال also يلقي الضوء briefly على موضوعات مرتبطة مثل Google Translate's architecture، agent skills workflow، و PostgreSQL's process-based design، ending with reflective questions for Readers.
المصدر: ByteByteGo · لخّصه HeadlinesBriefing