
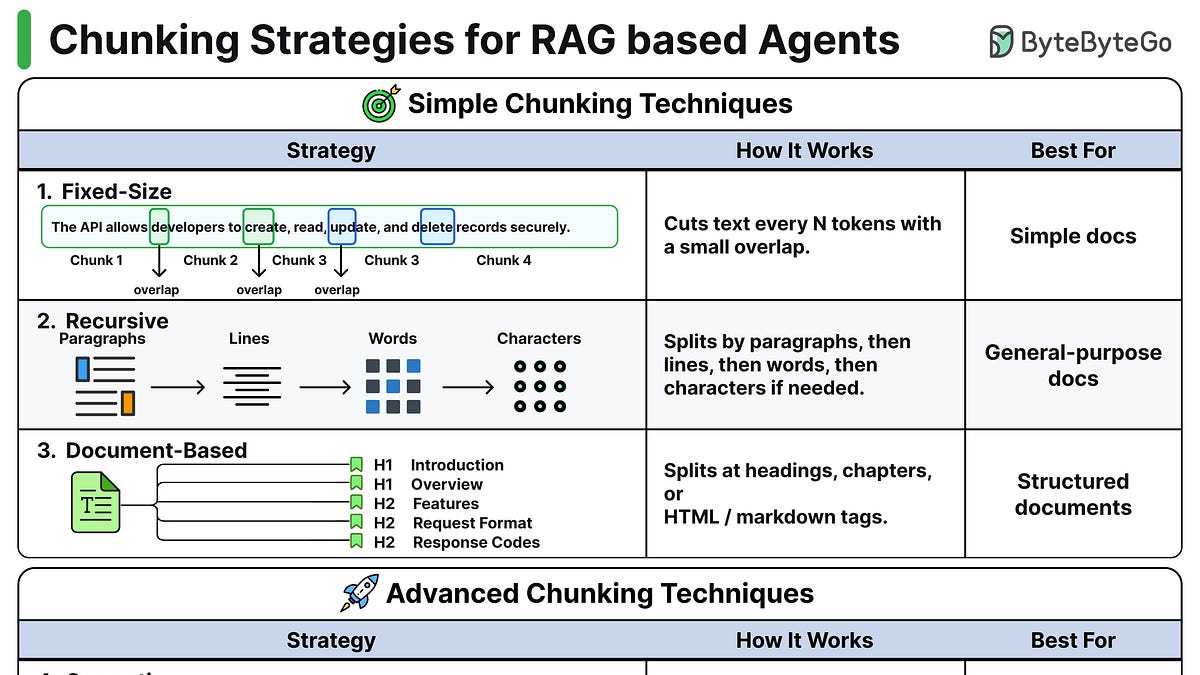
Este artículo describe ocho estrategias de chunking utilizadas en sistemas de generación aumentada por recuperación (RAG) para mejorar cómo los modelos de lenguaje grandes procesan el texto. El chunking de tamaño fijo divide el texto en bloques de tokens uniformes con solapamiento. El chunking recursivo divide por párrafo, luego por línea, palabra y carácter según sea necesario.
El chunking basado en documento utilizes rupturas estructurales existentes como encabezados o etiquetas HTML. El chunking semántico incrusta oraciones y comienza nuevos chunk cuando la similitud disminuye, detectando cambios reales de tema. El chunking basado en LLM utiliza un LLM para reescribir el texto en proposiciones independientes, una idea por chunk: alta calidad pero costoso.
El chunking agente permite que un agente de IA clasifique documentos (por ejemplo, código, contrato) y seleccione el método óptimo por archivo. El chunking tardío procesa el documento completo a través de un modelo de incrustación antes de dividir y hacer mean-pooling dentro de los límites. El chunking jerárquico crea estructuras capas desde secciones hasta oraciones.
La pieza también toca brevemente temas relacionados como la arquitectura de Google Translate, el flujo de trabajo de habilidades de agentes y el diseño basado en procesos de PostgreSQL, terminando con preguntas reflexivas para los lectores.
Fuente: ByteByteGo · Resumido por HeadlinesBriefing