
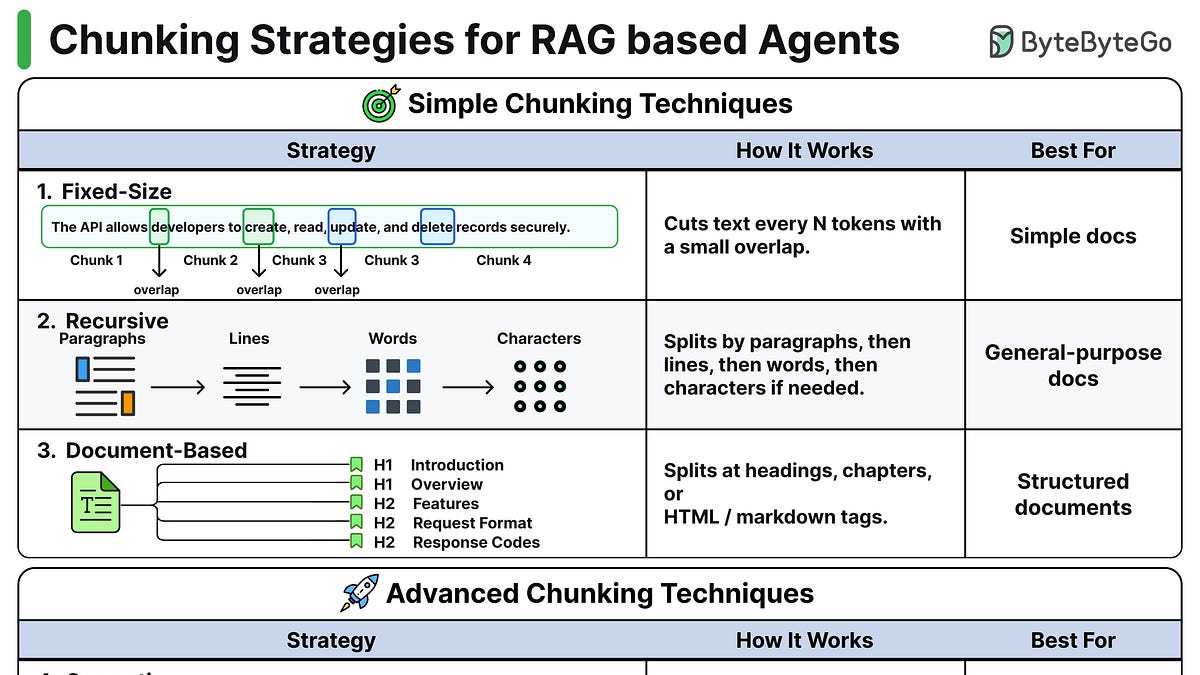
この記事では、大規模言語モデルがテキストを処理する方法を改善するために、 retrieval-augmented generation(RAG)システムで使用される8つのチャンキング戦略について説明します。固定サイズチャンキングは、テキストを均一なトークンブロックに重複付きで分割します。再帰的チャンキングは、必要に応じて段落、then行、単語、文字に分割します。文書ベースチャンキングは、見出しやHTMLタグなどの既存の構造的区切りを使用します。意味的チャンキングは文を埋め込み、類似度が下がると新しいチャンキングを開始し、実際のテーマ変化を検出します。LLMベースチャンキングは、LLMを使用してテキストを独立した命題に書き換えるため、1つのアイデア per チャンク—高品質だが高コスト。エージェントチャンキングは、AIエージェントが文書(コード、契約など)を分類し、各ファイル最適な方法を選択します。後期チャンキングは、分割前/embeddingモデルで全文書を処理し、境界内で平均プーリングを行います。階層的チャンキングは、セクションから文までレイヤー構造を作成します。この記事は、Google Translateのアーキテクチャ、エージェント skills workflow、PostgreSQLのプロセスベース設計など、関連トピックにも briefly 触れ、読者へのreflective questionsで締めくくらいます。
出典: ByteByteGo · 要約:HeadlinesBriefing