
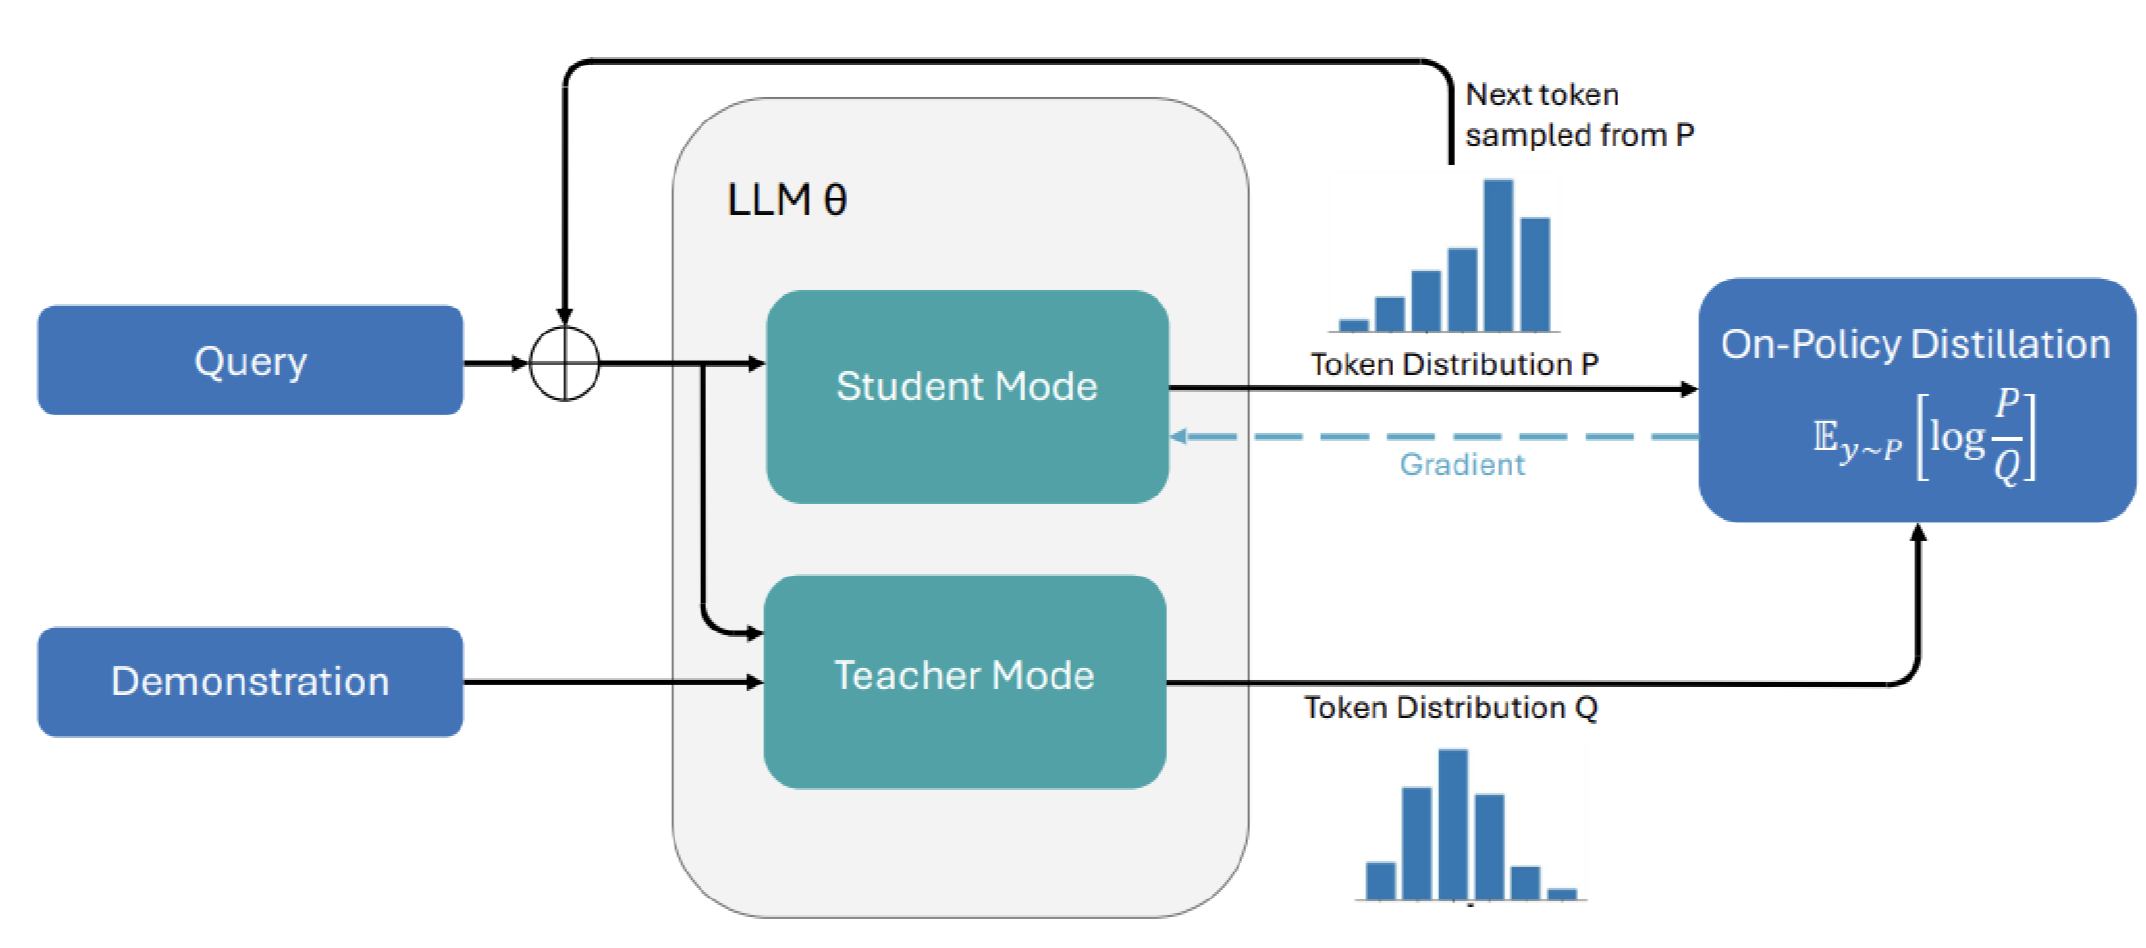
オンポリシー自己蒸留(OPSD)は、機械学習研究の主要テーマとして急速に広まりました。その枠組みは従来から確立された手法を基盤としていますが、このテーマに関する最初の論文は2026年1月下旬に登場したばかりで、その後わずかな期間に数十本もの論文が発表されています。本記事では主に、Shenfeldらが「Self-distillation enables continual learning」で提案した自己蒸留ファインチューニング(SDFT)の枠組みを通して、OPSDの文献を探ります。
その論文タイトルにある「継続学習(continual learning)」とは、モデルがデータストリームから効果的かつ動的に学習する能力を指します。本記事はまず、OPSDの枠組みが解決しようとする課題を検討します。その課題とは破滅的忘却です。これは、モデルが新しいタスクを学習する過程で、以前のタスクを処理する能力を失ってしまう現象です。基盤モデルの性能が向上するにつれ、複雑な用途やカスタマイズされたタスクのために事後学習を行うことが不可欠になっていますが、ゼロから事前学習を行うのは非常にコストがかかります。
続いて、SDFTの仕組みとその成功に関する理論的な説明を取り上げます。論文で報告された実験は有望な結果を示しており、OPSDが広く適用可能である可能性を裏付けています。最後に、この手法をめぐって浮上してきた二つの中心的な懸念に触れます。
出典: Towards Data Science · 要約:HeadlinesBriefing