
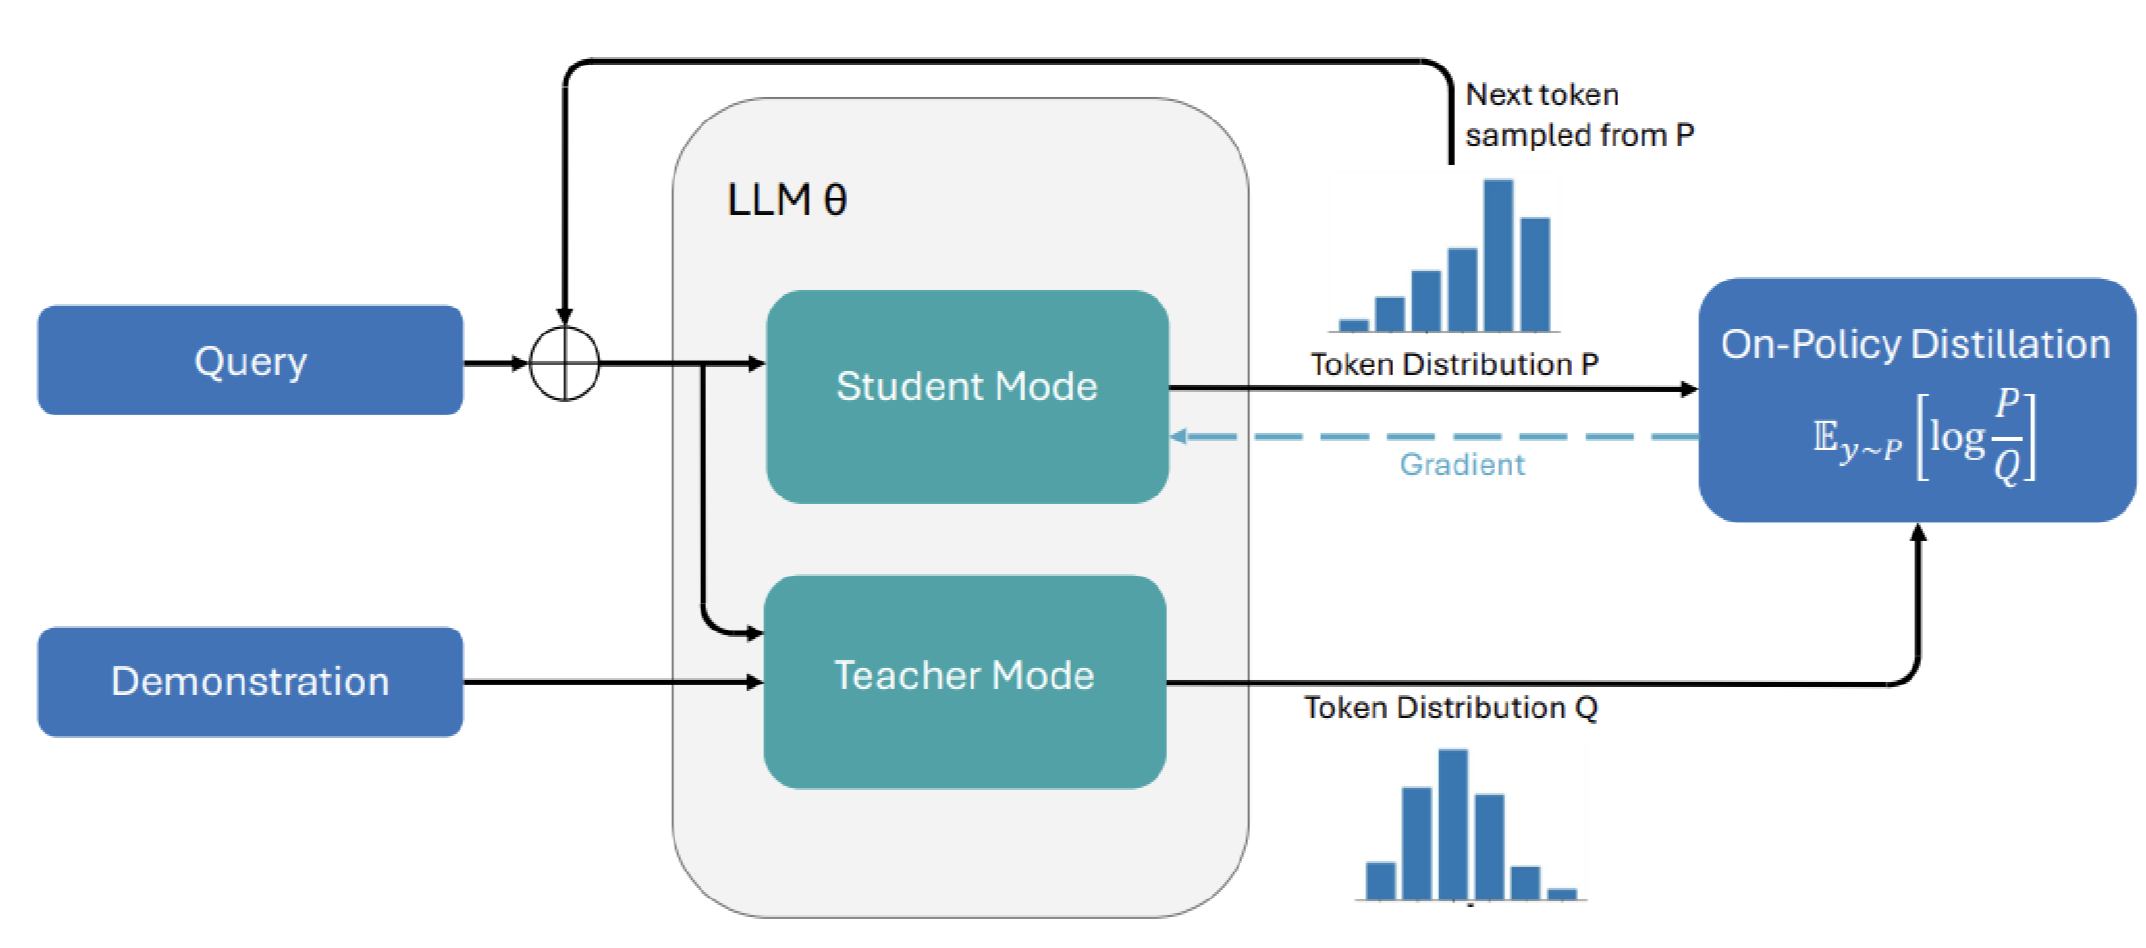
On-Policy-Selbstdistillation (OPSD) hat sich rasch zu einem zentralen Thema der Machine-Learning-Forschung entwickelt. Obwohl ihre Frameworks auf älteren, etablierten Ansätzen aufbauen, erschienen die ersten Arbeiten zu diesem Thema erst Ende Januar 2026, und in kurzer Zeit folgten mehrere Dutzend weitere. Dieser Artikel untersucht die Literatur zu OPSD vor allem aus der Perspektive des Self-Distillation Fine-Tuning (SDFT)-Frameworks, das Shenfeld et al. in „Self-distillation enables continual learning“ vorgestellt haben.
Der Begriff „kontinuierliches Lernen“ im Titel dieser Arbeit bezeichnet die Fähigkeit eines Modells, aus einem Datenstrom effektiv und dynamisch zu lernen. Der Artikel beginnt mit dem Problem, das OPSD-Frameworks lösen sollen: das katastrophale Vergessen, bei dem Modelle die Fähigkeit verlieren, ältere Aufgaben zu bewältigen, während sie neue erlernen. Da Foundation-Modelle immer leistungsfähiger werden, ist ihr Post-Training für komplexe oder maßgeschneiderte Aufgaben unverzichtbar, denn ein Pre-Training von Grund auf wäre unerschwinglich teuer.
Anschließend betrachtet der Artikel die Funktionsweise von SDFT und die theoretischen Erklärungen für seinen Erfolg. Die in der Arbeit berichteten Experimente zeigen vielversprechende Ergebnisse und stützen die Aussicht, dass OPSD breit anwendbar ist. Abschließend werden zwei zentrale Bedenken angesprochen, die im Zusammenhang mit der Methode aufgekommen sind.
Quelle: Towards Data Science · Zusammengefasst von HeadlinesBriefing