
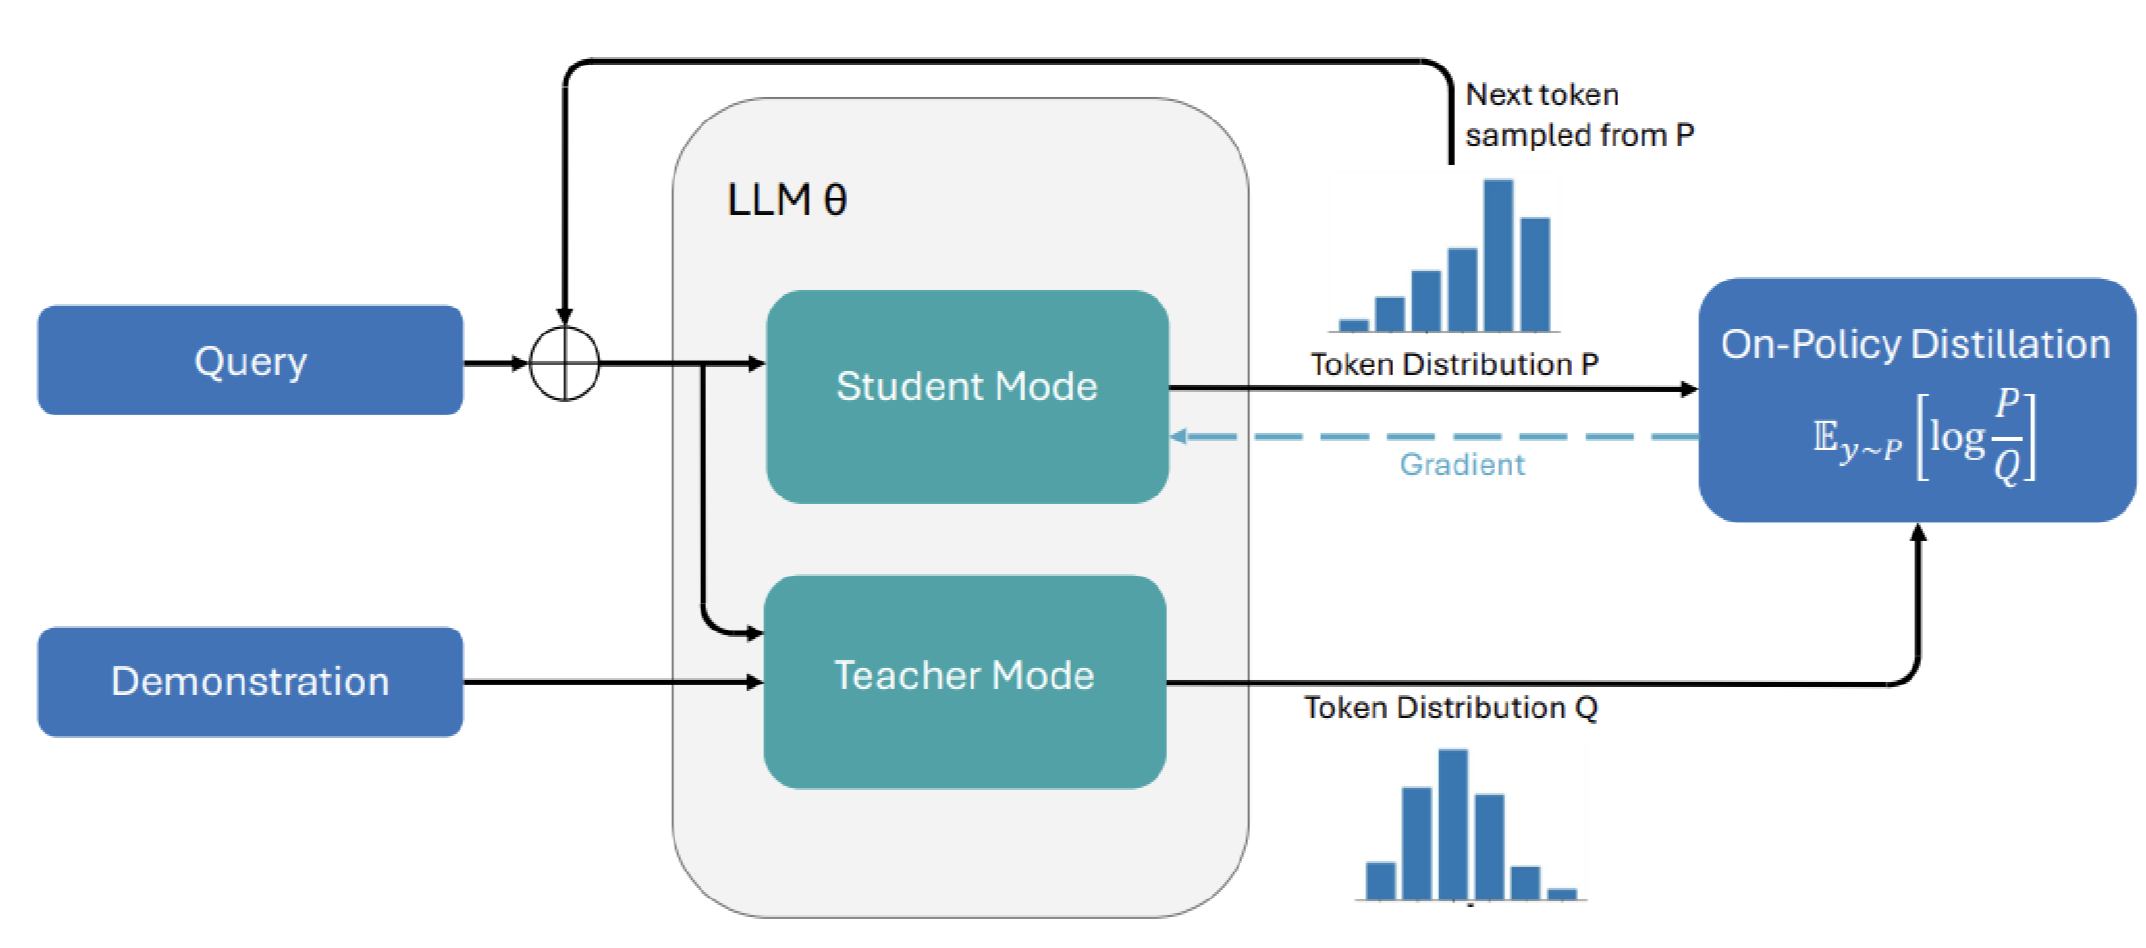
L'autodistillation on-policy (OPSD) est devenue en peu de temps un sujet majeur de la recherche en apprentissage automatique. Bien que ses cadres reposent sur des approches plus anciennes et bien établies, les premiers articles sur le sujet n'ont paru qu'à la fin janvier 2026, et plusieurs dizaines d'autres ont suivi en un temps très court. Cet article explore la littérature sur l'OPSD, principalement à travers le prisme du cadre d'autodistillation pour le réglage fin (SDFT) introduit par Shenfeld et al. dans « Self-distillation enables continual learning ».
Le terme « apprentissage continu » dans le titre de cet article désigne la capacité d'un modèle à apprendre efficacement et dynamiquement à partir d'un flux de données. L'article commence par examiner le problème que les cadres OPSD cherchent à résoudre : l'oubli catastrophique, par lequel les modèles perdent la capacité de traiter les anciennes tâches à mesure qu'ils en apprennent de nouvelles. À mesure que les modèles de fondation gagnent en puissance, leur post-entraînement pour des tâches complexes ou personnalisées devient essentiel, car un entraînement depuis zéro serait prohibitif.
L'article examine ensuite le fonctionnement de SDFT et les explications théoriques de son succès. Les expériences rapportées dans l'article montrent des résultats prometteurs, renforçant la perspective d'une application large de l'OPSD. Enfin, il aborde deux préoccupations majeures apparues concernant la méthode.
Source: Towards Data Science · Résumé par HeadlinesBriefing