
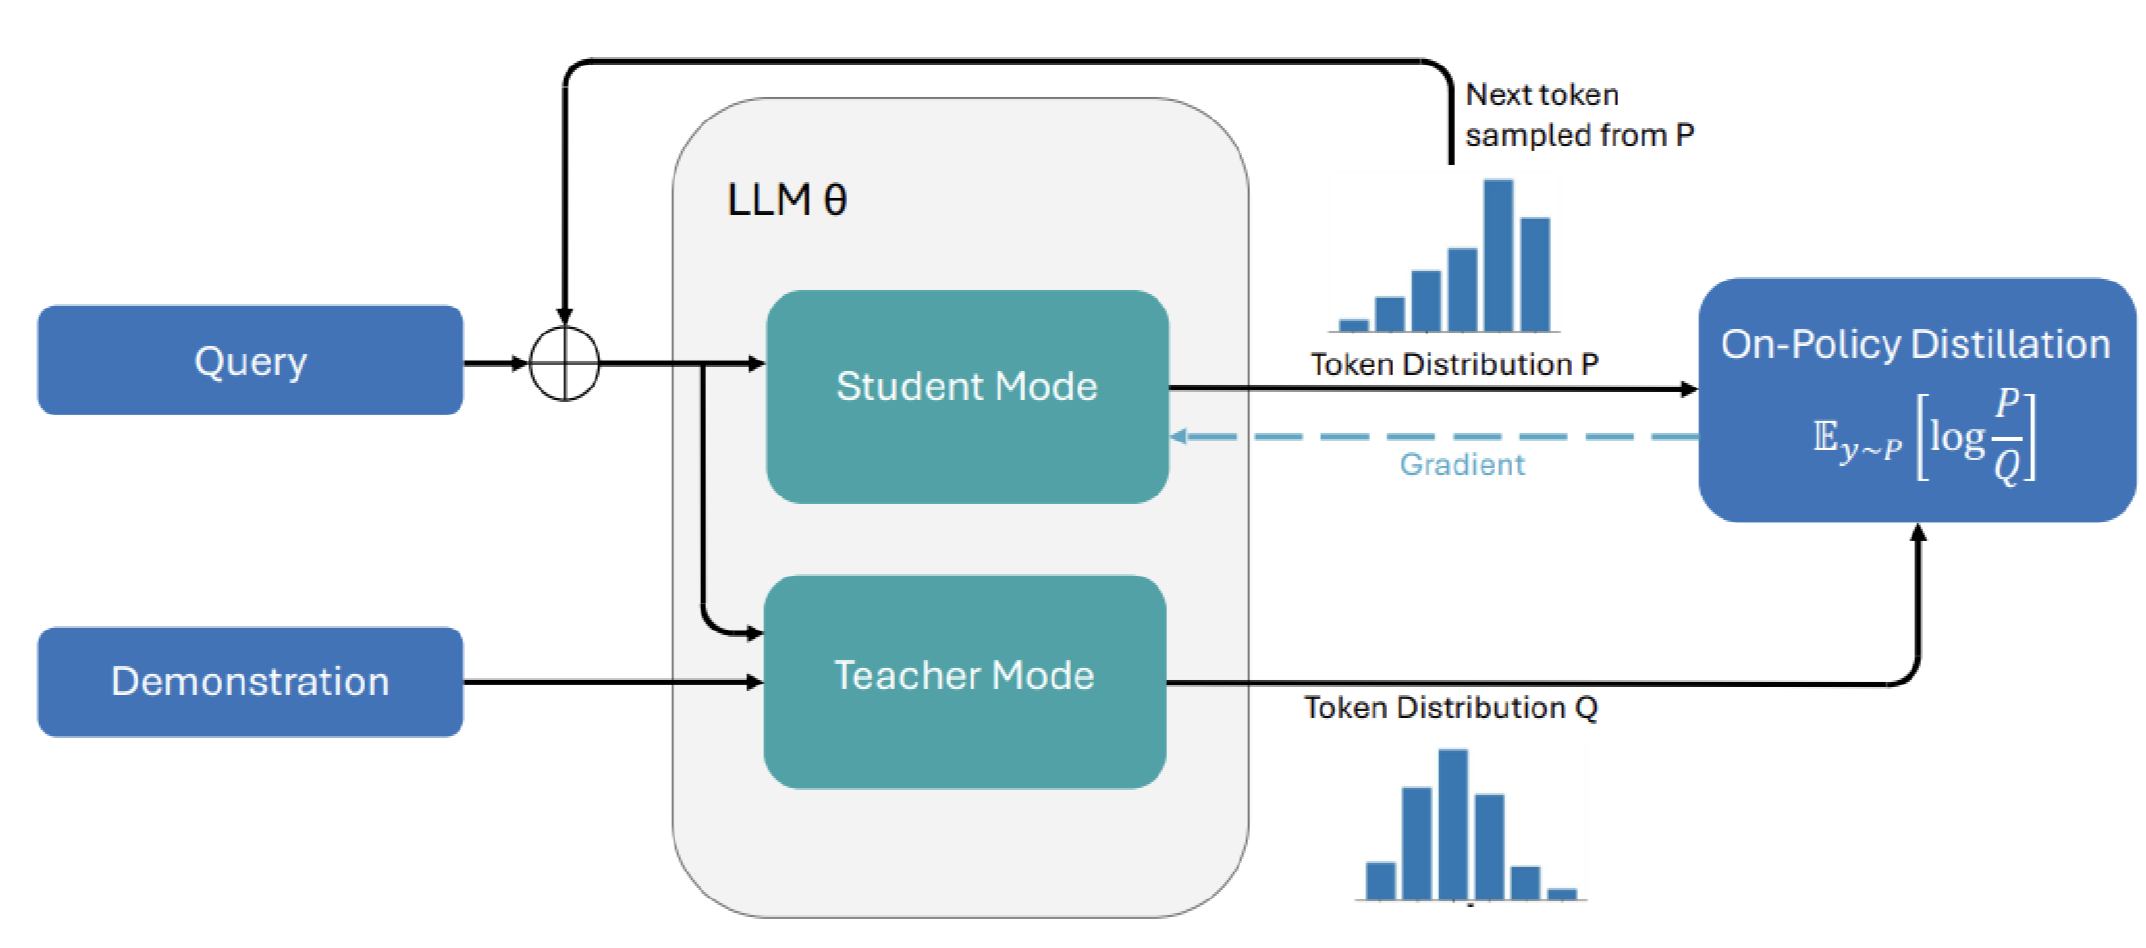
Self-distillation on-policy (OPSD) dengan cepat menjadi topik utama dalam riset machine learning. Meskipun kerangkanya dibangun di atas pendekatan lama yang sudah mapan, makalah pertama tentang topik ini baru muncul pada akhir Januari 2026, dan beberapa lusin menyusul dalam waktu singkat. Artikel ini menelaah literatur OPSD, terutama melalui kacamata kerangka Self-Distillation Fine-Tuning (SDFT) yang diperkenalkan Shenfeld dkk. dalam "Self-distillation enables continual learning".
Istilah "continual learning" dalam judul makalah tersebut merujuk pada kemampuan model untuk belajar secara efektif dan dinamis dari aliran data. Artikel ini dimulai dengan membahas masalah yang ingin dipecahkan kerangka OPSD: catastrophic forgetting, yaitu ketika model kehilangan kemampuan menangani tugas lama saat mempelajari tugas baru. Seiring foundation model semakin kuat, post-training untuk tugas yang kompleks atau khusus menjadi penting, karena pre-training dari awal sangat mahal.
Artikel ini kemudian membahas cara kerja SDFT dan penjelasan teoretis atas keberhasilannya. Eksperimen yang dilaporkan dalam makalah menunjukkan hasil yang menjanjikan, memperkuat prospek OPSD agar dapat diterapkan secara luas. Terakhir, artikel ini menyinggung dua kekhawatiran utama yang muncul terkait metode tersebut.
Sumber: Towards Data Science · Diringkas oleh HeadlinesBriefing