
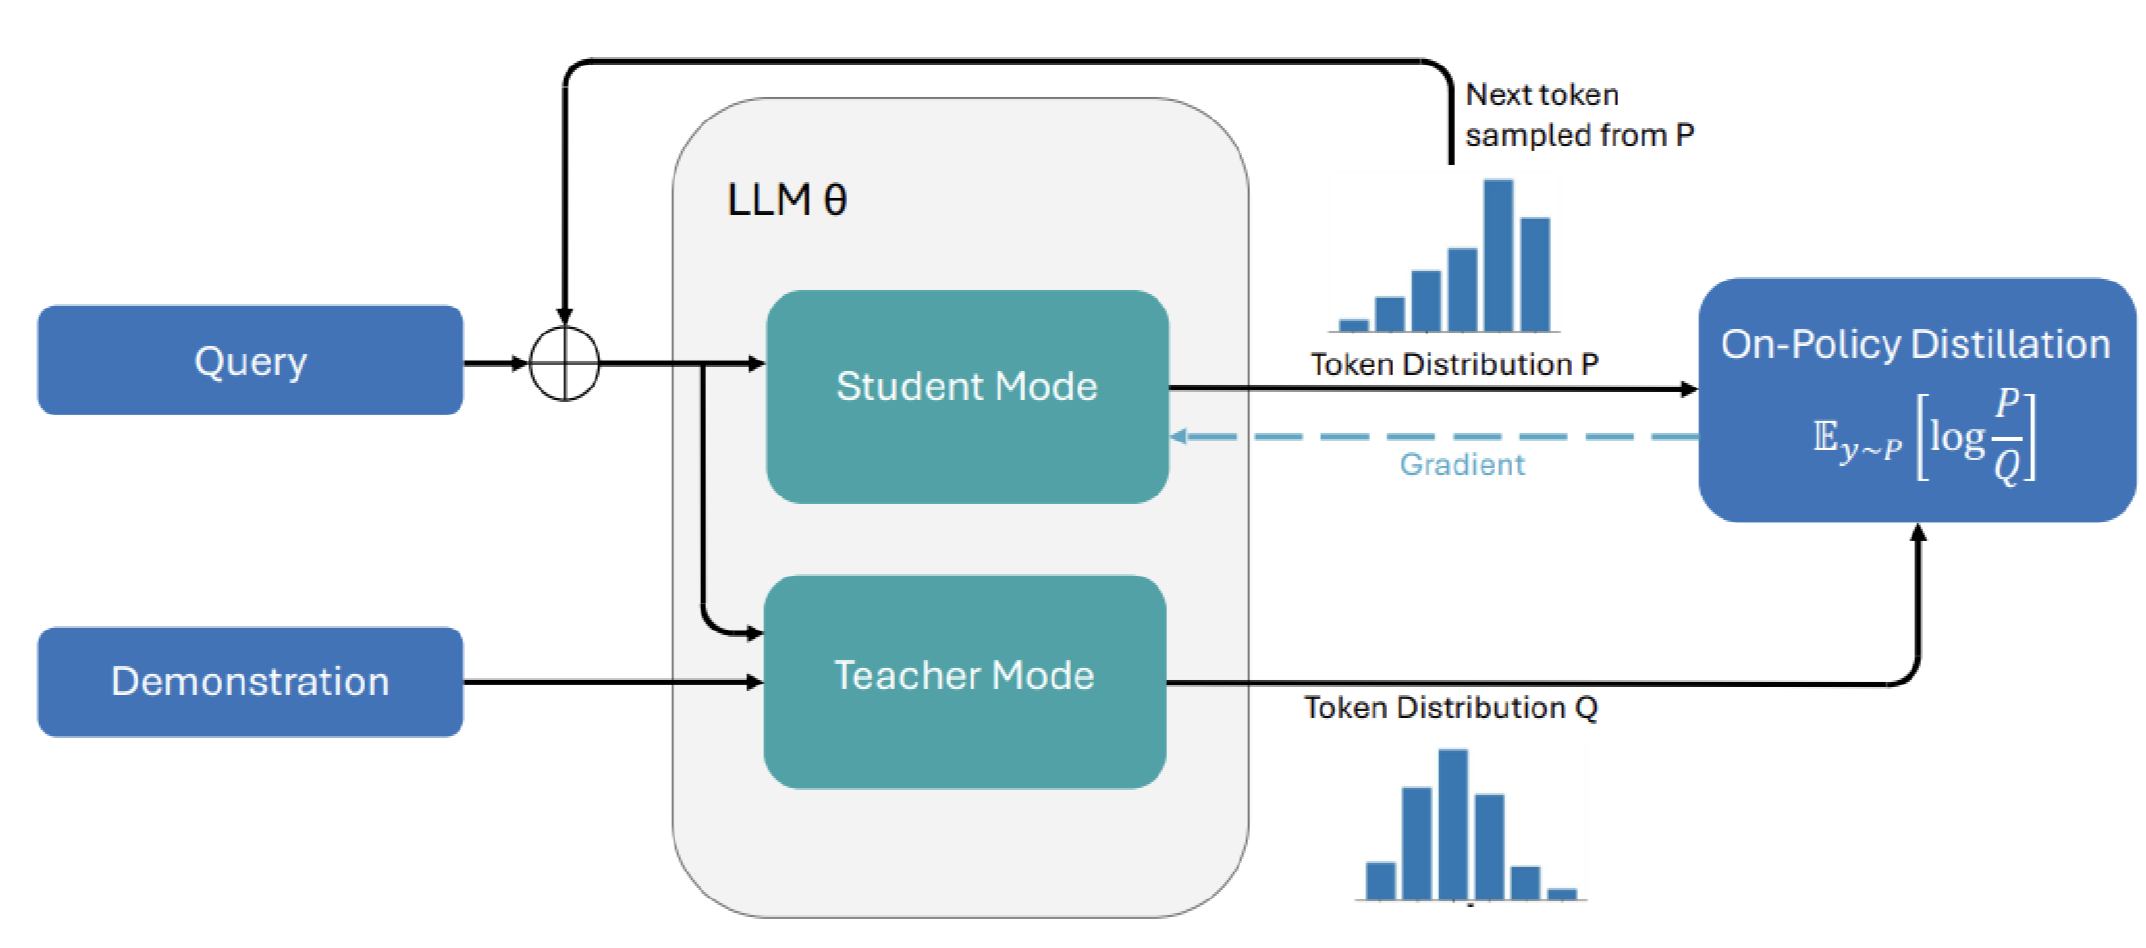
On-policy самодистилляция (OPSD) быстро стала одной из ключевых тем в исследованиях машинного обучения. Хотя её фреймворки опираются на более давние, устоявшиеся подходы, первые статьи на эту тему появились лишь в конце января 2026 года, и за короткое время за ними последовало несколько десятков других. Эта статья рассматривает литературу по OPSD главным образом через призму фреймворка тонкой настройки с самодистилляцией (SDFT), представленного Шенфельдом и соавторами в работе «Self-distillation enables continual learning».
Термин «непрерывное обучение» в названии этой работы относится к способности модели эффективно и динамично обучаться на основе потока данных. Статья начинается с рассмотрения проблемы, которую призваны решить фреймворки OPSD: катастрофического забывания, при котором модели утрачивают способность решать старые задачи по мере освоения новых. По мере того как базовые модели становятся мощнее, их дообучение для сложных или специализированных задач становится необходимым, поскольку обучение с нуля слишком дорого.
Затем статья рассматривает, как работает SDFT, и теоретические объяснения его успеха. Эксперименты, описанные в работе, демонстрируют многообещающие результаты, что говорит в пользу широкой применимости OPSD. Наконец, в статье затрагиваются две ключевые проблемы, возникшие в связи с этим методом.
Источник: Towards Data Science · Сводку подготовил HeadlinesBriefing