
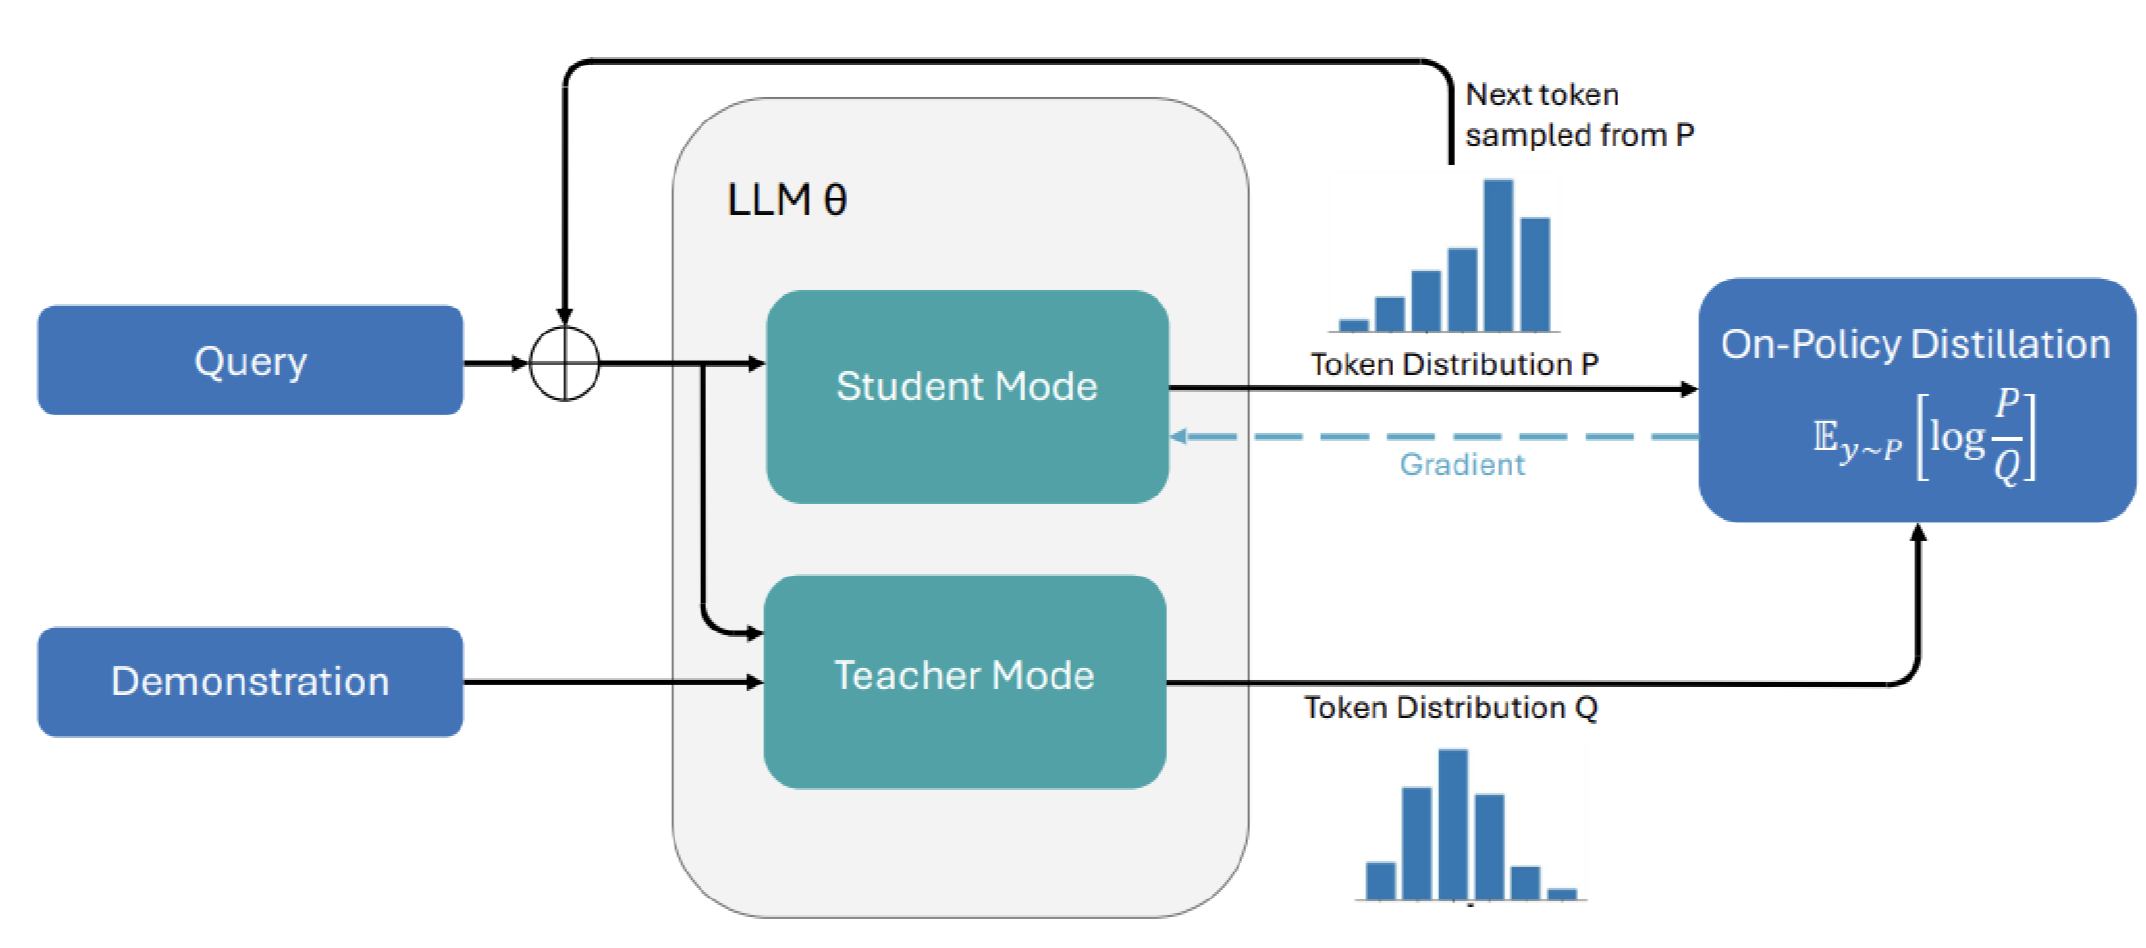
ऑन-पॉलिसी सेल्फ-डिस्टिलेशन (OPSD) मशीन लर्निंग अनुसंधान का एक प्रमुख विषय बन गया है। यद्यपि इसके ढांचे पुराने, स्थापित तरीकों पर आधारित हैं, फिर भी इस विषय पर पहले शोधपत्र केवल जनवरी 2026 के अंत में प्रकाशित हुए, और एक छोटी सी अवधि में ही इनके कई दर्जन और आ गए। यह लेख मुख्य रूप से Shenfeld आदि द्वारा "Self-distillation enables continual learning" में प्रस्तुत सेल्फ-डिस्टिलेशन फाइन-ट्यूनिंग (SDFT) ढांचे के दृष्टिकोण से OPSD साहित्य की पड़ताल करता है।
उस शोधपत्र के शीर्षक में "कंटीन्यूअल लर्निंग" शब्द का अर्थ है, किसी मॉडल की वह क्षमता जिससे वह डेटा-स्ट्रीम से प्रभावी और गतिशील रूप से सीख सके। यह लेख उस समस्या की जांच से शुरू होता है जिसे OPSD ढांचे हल करना चाहते हैं: कैटस्ट्रोफिक फॉरगेटिंग, जिसमें मॉडल नए कार्य सीखते समय पुराने कार्यों को संभालने की क्षमता खो देते हैं। जैसे-जैसे फाउंडेशन मॉडल अधिक शक्तिशाली हो रहे हैं, जटिल या अनुकूलित कार्यों के लिए उन्हें पोस्ट-ट्रेन करना आवश्यक हो गया है, क्योंकि शून्य से प्री-ट्रेनिंग अत्यधिक महंगी है।
इसके बाद लेख SDFT के काम करने के तरीके और इसकी सफलता के सैद्धांतिक स्पष्टीकरणों को देखता है। शोधपत्र में बताए गए प्रयोग आशाजनक परिणाम दिखाते हैं, जिससे OPSD के व्यापक रूप से लागू होने की संभावना को बल मिलता है। अंत में, यह इस विधि को लेकर उभरी दो मुख्य चिंताओं पर चर्चा करता है।
स्रोत: Towards Data Science · HeadlinesBriefing द्वारा सारांशित