
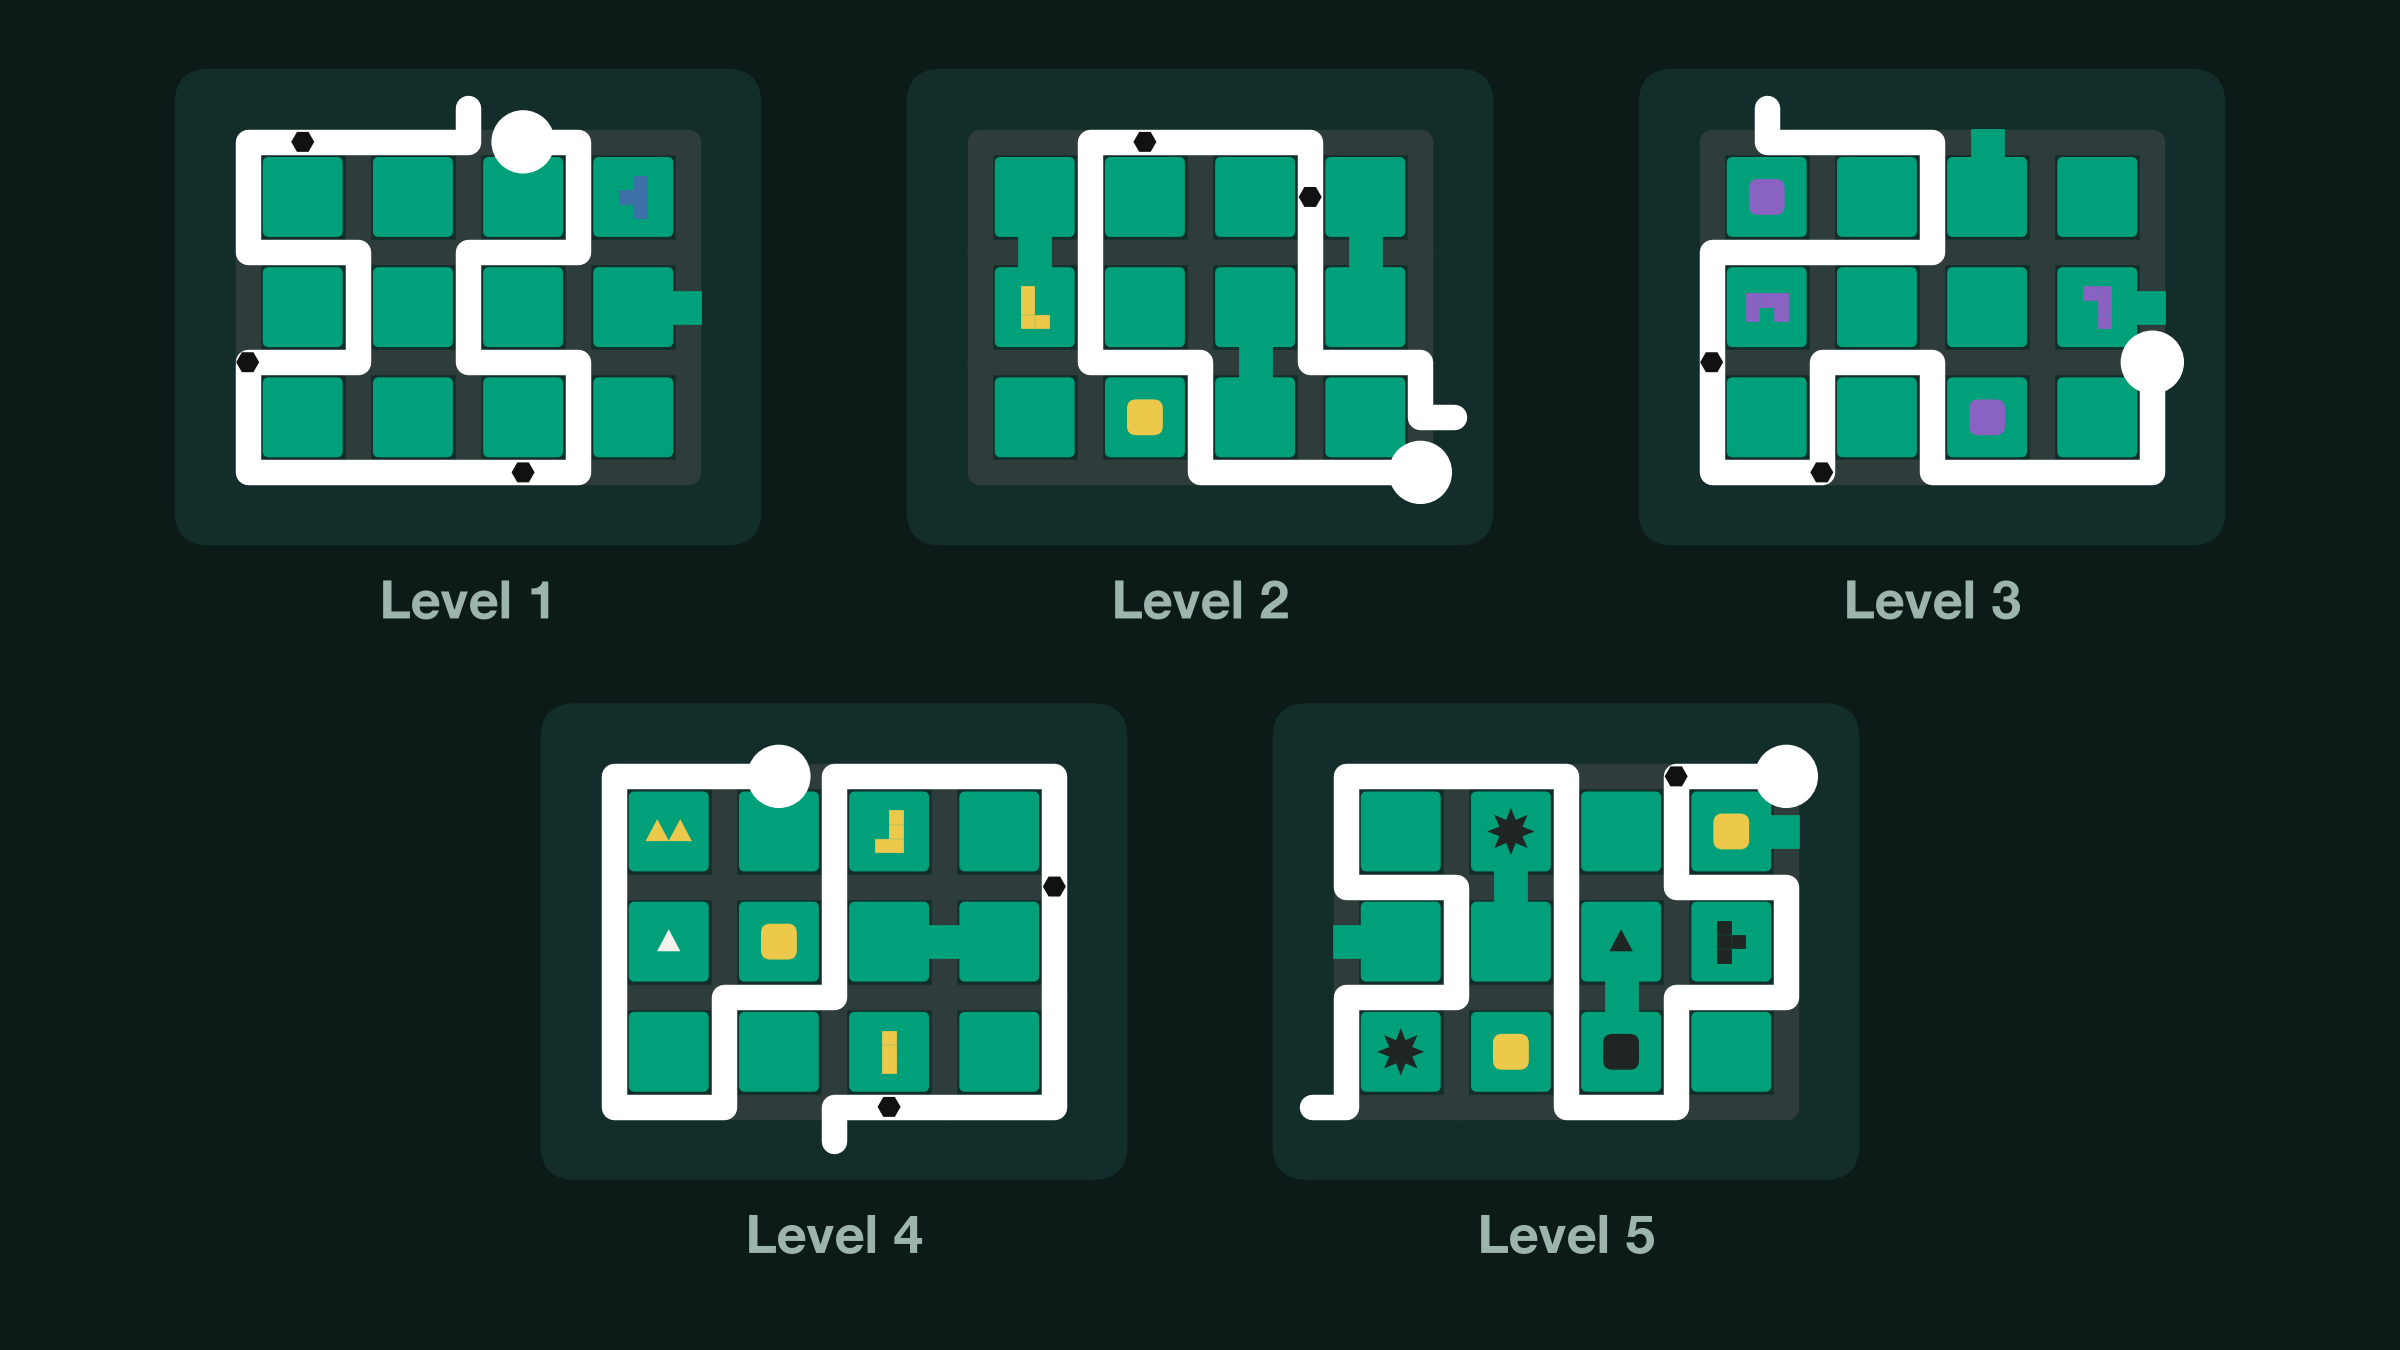
इस अध्ययन में लोगों ने ग्रिड पहेलियों के 98.0% हल किए, आसान पहेली में लगभग 11 सेकंड और सबसे कठिन में दो मिनट से कुछ अधिक समय लगा। परीक्षण किए गए सर्वश्रेष्ठ मॉडल, GPT-6.1 Sol, उनमें से 83.6% हल करता है। यह मानव के करीब लगता है, लेकिन सबसे कठिन स्तर पर यह 49.4% हल करता है, जबकि लोग 94.5% हल करते हैं।
इनमें से एक पहेली हल करने के लिए कई अलग-अलग कौशल चाहिए, और एक ही सटीकता संख्या यह छिपा देती है कि मॉडल में कौन सा कौशल कमजोर है। इसलिए शोधकर्ताओं ने कार्य को चार प्रश्नों में बांटा: क्या मॉडल बोर्ड पढ़ सकते हैं, खासकर किसी छवि से? क्या वे अपनी रेखा का ट्रैक रख सकते हैं? क्या वे नियमों का पालन कर सकते हैं? क्या पहेली कठिन होने पर वे अधिक प्रयास करते हैं? यह पोस्ट तीन शोधपत्रों पर आधारित है, जिनमें EMNLP 2025 में प्रकाशित SPa RC, एक स्थानिक पथ-खोज तर्क चुनौती भी शामिल है।
हर पहेली हरे सेलों का एक बोर्ड है जो भूरी गलियों से जुड़ा है। खिलाड़ी किनारे पर स्थित एक बड़े वृत्त से एक ऐसी रेखा खींचता है जो स्वयं को न काटे और बाहर निकलने के स्टब तक पहुंचे। प्रतीक तय करते हैं कि कौन सी रेखाएं मान्य हैं: बिंदुओं का रेखा पर होना आवश्यक है, अंतराल गली के खंडों को रोकते हैं, और अलग-अलग रंगों के पत्थरों को रेखा द्वारा बंद किए गए अलग क्षेत्रों में होना चाहिए। यदि कोई रेखा दोनों बिंदुओं से गुजरती है पर बैंगनी, काले और लाल पत्थर को एक ही क्षेत्र में छोड़ देती है, तो वह पत्थर के नियम को तोड़ती है, और सही हल बोर्ड पर एक लंबा मार्ग लेता है।
लोगों ने पहेलियां एक ड्राइंग ऐप में हल कीं, लेकिन मॉडल को आमतौर पर बोर्ड निर्देशांक वाली पाठ-ग्रिड के रूप में मिलता है। मॉडल अपना तर्क समझाते हैं और फिर रेखा को चरण-दर-चरण स्थितियों की सूची के रूप में लिखते हैं। पूर्ण बेंचमार्क में सात नियम प्रकार हैं, और सबसे कठिन पहेलियों पर मनुष्यों और मॉडलों के बीच का अंतर दिखाता है कि वर्तमान प्रणालियां अभी भी कहां संघर्ष करती हैं।
स्रोत: Towards Data Science · HeadlinesBriefing द्वारा सारांशित