
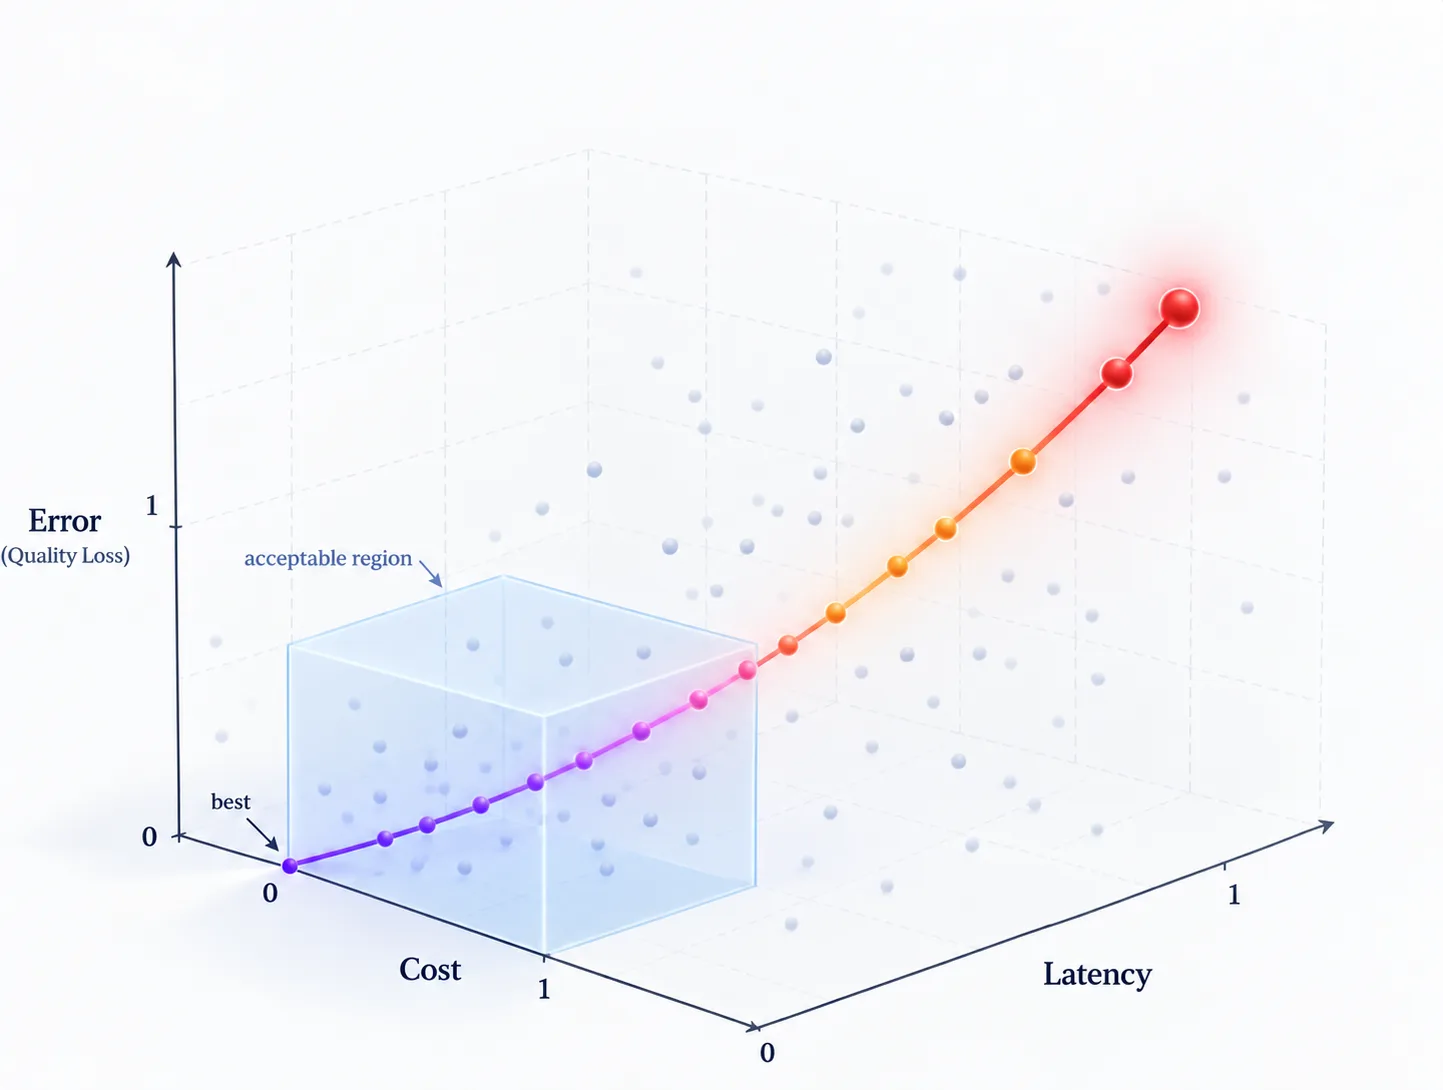
यह लेख उत्पादन एजेंट प्रणालियों में एक व्यावहारिक समस्या से निपटता है: परस्पर विरोधी मूल्यांकन मापदंडों को एक सार्थक, एकल स्कोर में मिलाना जो कई टीमों के उद्देश्यों को दर्शाए। टीमों को सटीकता, लागत, गति और विश्वसनीयता के बीच संतुलन बनाना होता है, और एक आयाम को अनुकूलित करने से अक्सर दूसरे को नुकसान पहुँचता है।
लेखक का तर्क है कि अधिकांश टीमों के पास पहले से ही आवश्यक सामग्री मौजूद है, जिसमें Jira टिकट, PM आवश्यकताएँ, वित्त बजट, SLO, सपोर्ट टिकट, ट्रेस और मूल्यांकन डेटासेट शामिल हैं। जो अक्सर गायब रहता है वह व्यावसायिक उद्देश्यों और एजेंट कॉन्फ़िगरेशन निर्णयों के बीच एक अनुवाद परत है। प्रोडक्ट गुणवत्ता की न्यूनतम सीमा तय करता है, वित्त लागत की अधिकतम सीमा, इंजीनियरिंग विलंबता और विश्वसनीयता की सीमाएँ, और जोखिम विभाग नीति संबंधी बाध्यताएँ। फिर हर एजेंट कॉन्फ़िगरेशन को एक ही साझा बॉक्स के आधार पर स्कोर किया जाता है।
इस ट्रेड-ऑफ़ को नज़रअंदाज़ करने की कीमत मापी जा सकती है। CLEAR फ्रेमवर्क का हवाला देते हुए लेख बताता है कि समान सटीकता वाले एजेंटों की लागत में 50 गुना तक अंतर हो सकता है, और जब आठ रनों में स्थिरता मापी गई तो एजेंट की सफलता दर एक ही रन में 60% से गिरकर 25% हो गई। ये निष्कर्ष एक ही प्रीप्रिंट से आते हैं, लेकिन लेखक का कहना है कि इनकी दिशा वही है जो कई टीमें उत्पादन में देखती हैं।
मूल सिद्धांत यह है कि पहले बॉक्स के भीतर रहें, फिर उसी के भीतर अनुकूलन करें। एजेंट के असफल होने के कारण समझाने के लिए घटक मापदंड अब भी आवश्यक हैं, लेकिन एक एकल समग्र स्कोर उस स्थिति को रोकता है जहाँ कोई मॉडल गुणवत्ता बढ़ाते हुए विलंबता को ग्राहक की धैर्य सीमा से आगे धकेल देता है और बार-बार बहस का कारण बनता है। लेख बॉक्स को सरल भाषा में परिभाषित करता है, लगभग 40 पंक्तियों के NumPy में एक स्कोरिंग फ़ंक्शन बनाता है, दो नमूना कॉन्फ़िगरेशन की तुलना करता है, और दिखाता है कि यह स्कोर LangSmith, Phoenix और DSPy जैसे मूल्यांकन उपकरणों में कैसे जोड़ा जा सकता है।
स्रोत: Towards Data Science · HeadlinesBriefing द्वारा सारांशित