
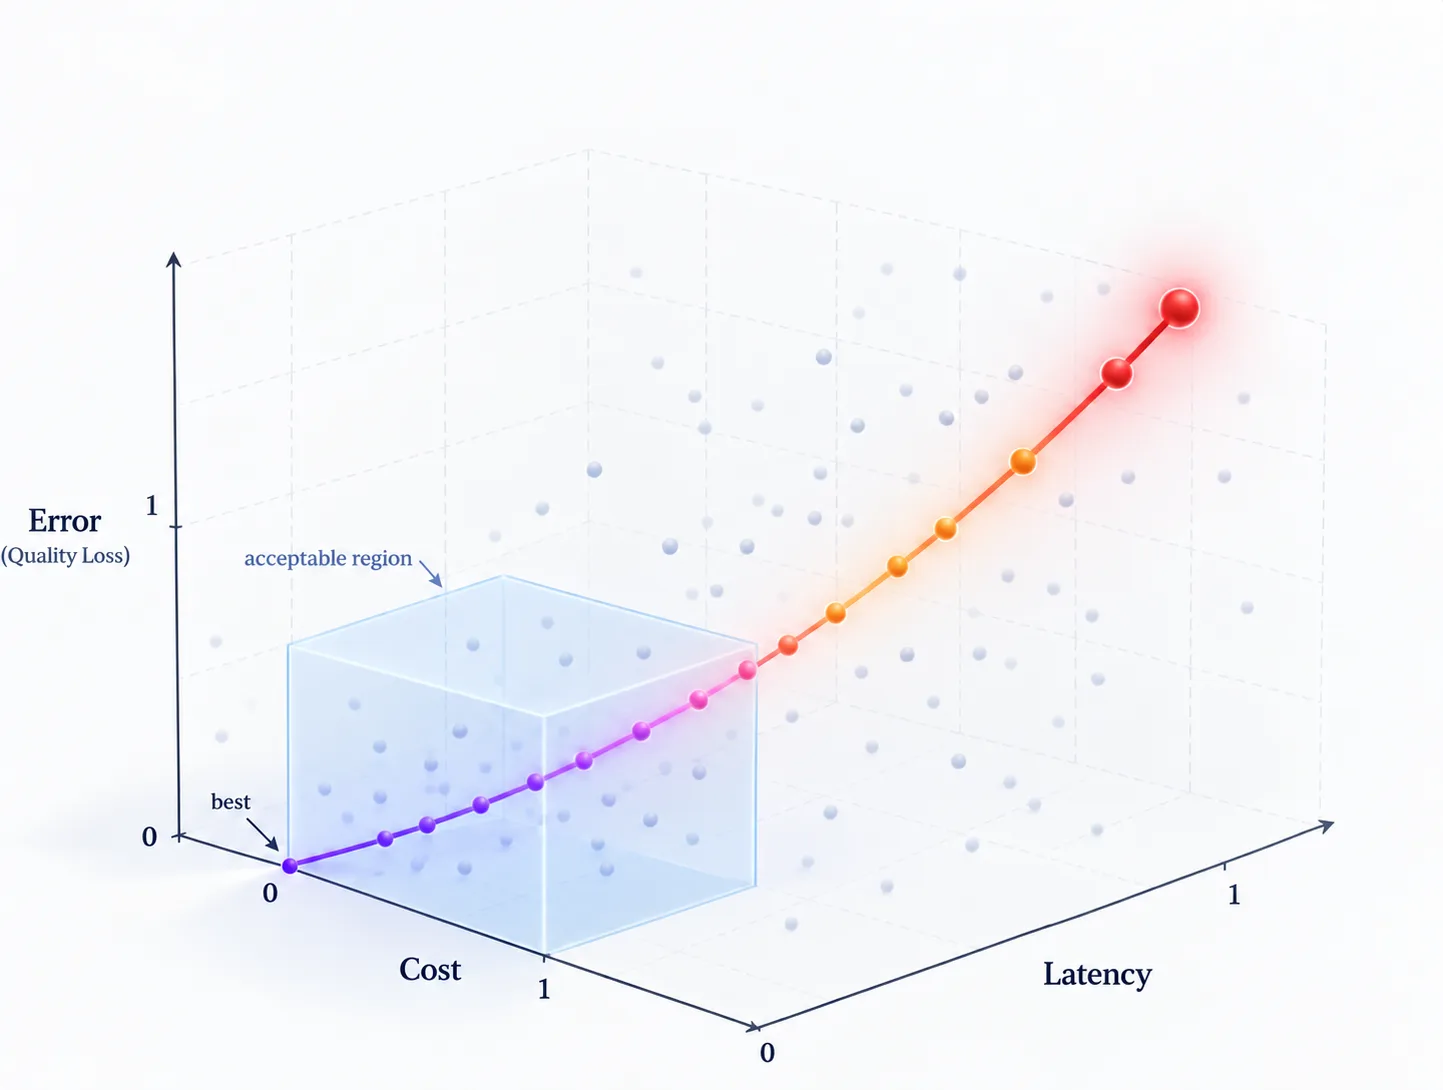
Este artigo aborda um problema prático em sistemas de agentes em produção: unir métricas de avaliação concorrentes em uma pontuação única e significativa que reflita os objetivos de múltiplas equipes. As equipes precisam equilibrar precisão, custo, velocidade e confiabilidade, e otimizar uma dimensão frequentemente prejudica outra.
O autor argumenta que a maioria das equipes já tem os ingredientes necessários, incluindo tickets do Jira, requisitos de produto, orçamentos financeiros, SLOs, tickets de suporte, rastros e conjuntos de dados de avaliação. O que costuma faltar é uma camada de tradução entre os objetivos de negócio e as decisões de configuração dos agentes. Produto define os pisos de qualidade, finanças define os tetos de custo, engenharia define os limites de latência e confiabilidade, e risco define as restrições de política. Cada configuração de agente é então pontuada dentro da mesma caixa compartilhada.
O custo de ignorar essa troca é mensurável. Citando o framework CLEAR, o artigo observa que agentes com precisão semelhante podem diferir em custo em até 50 vezes, e que o sucesso dos agentes caiu de 60% em uma única execução para 25% quando a consistência foi medida em oito execuções. Esses resultados vêm de um único preprint, mas o autor afirma que a direção coincide com o que muitas equipes observam em produção.
O princípio central é permanecer primeiro dentro da caixa e só então otimizar dentro dela. Métricas por componente continuam necessárias para explicar por que um agente falhou, mas uma pontuação composta evita que um modelo que melhora a qualidade enquanto empurra a latência além dos limites de paciência dos clientes se torne um debate recorrente. O artigo define a caixa em linguagem simples, constrói uma função de pontuação em cerca de 40 linhas de NumPy, compara duas configurações de exemplo e mostra como a pontuação pode ser integrada a ferramentas de avaliação como LangSmith, Phoenix e DSPy.
Fonte: Towards Data Science · Resumido por HeadlinesBriefing