
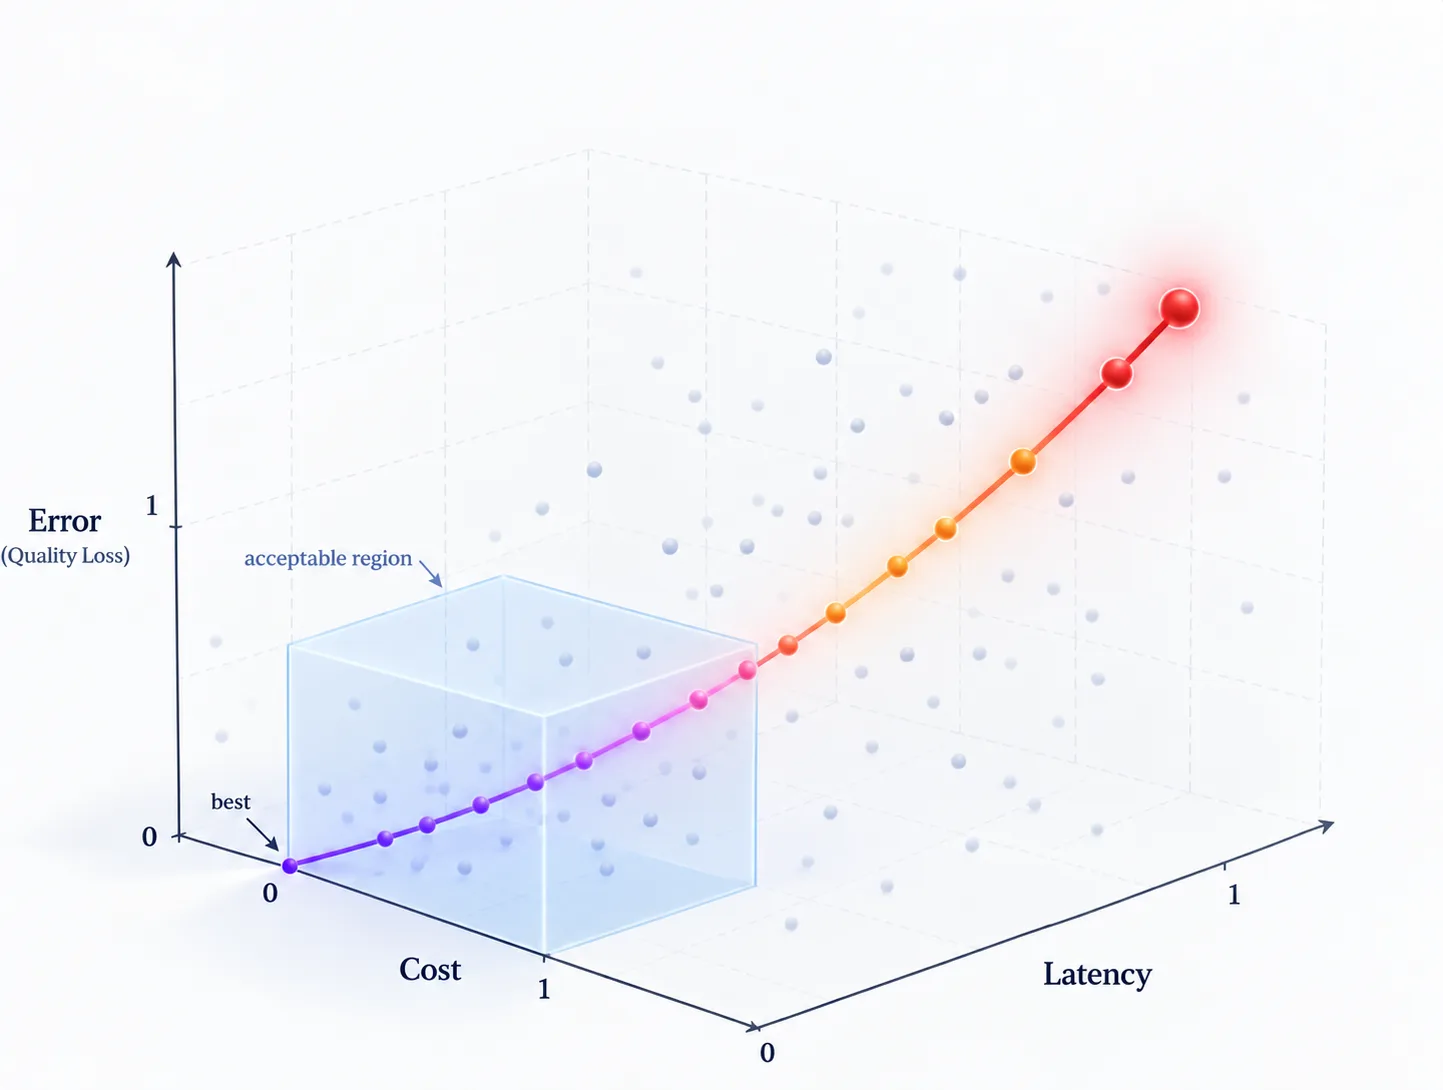
本記事では、本番環境のエージェントシステムにおける実務上の課題を取り上げます。それは、相反する評価指標を、複数チームの目標を反映した一つの意味あるスコアに統合することです。チームは精度、コスト、速度、信頼性のバランスを取らなければならず、ある要素を最適化すると別の要素が損なわれることがよくあります。
著者は、多くのチームがすでに必要な材料を持っていると主張します。それには、Jiraチケット、プロダクト要件、財務予算、SLO、サポートチケット、トレース、評価データセットが含まれます。しかし、多くの場合欠けているのは、ビジネス目標とエージェント構成の判断をつなぐ変換層です。プロダクトチームが品質の下限を定め、財務チームがコストの上限を定め、エンジニアリングチームがレイテンシと信頼性の閾値を定め、リスク担当チームがポリシー上の制約を定めます。そのうえで、各エージェント構成を同一の共通の枠組みに基づいて採点します。
このトレードオフを無視する代償は測定可能です。CLEARフレームワークを引用しながら、本記事は、精度が近いエージェント同士でもコストは最大50倍異なりうること、また一貫性を8回の実行で測定すると、エージェントの成功率が単一実行時の60%から25%に低下したことを指摘しています。これらの知見は一つのプレプリントに基づくものですが、著者は、その傾向が多くのチームが本番環境で目にしているものと一致すると述べています。
中核となる原則は、まず枠組みの内側にとどまり、そのうえでその内側で最適化することです。エージェントがなぜ失敗したのかを説明するには、コンポーネントごとの指標が依然として必要です。しかし単一の複合スコアがあれば、品質を高める一方でレイテンシを顧客の忍耐の限界を超えて悪化させるモデルが、繰り返し議論の的になるのを防げます。本記事は、この枠組みを平易な言葉で定義し、約40行のNumPyでスコアリング関数を構築し、2つのサンプル構成を比較し、そのスコアがLangSmith、Phoenix、DSPyなどの評価ツールにどのように組み込めるかを示しています。
出典: Towards Data Science · 要約:HeadlinesBriefing