
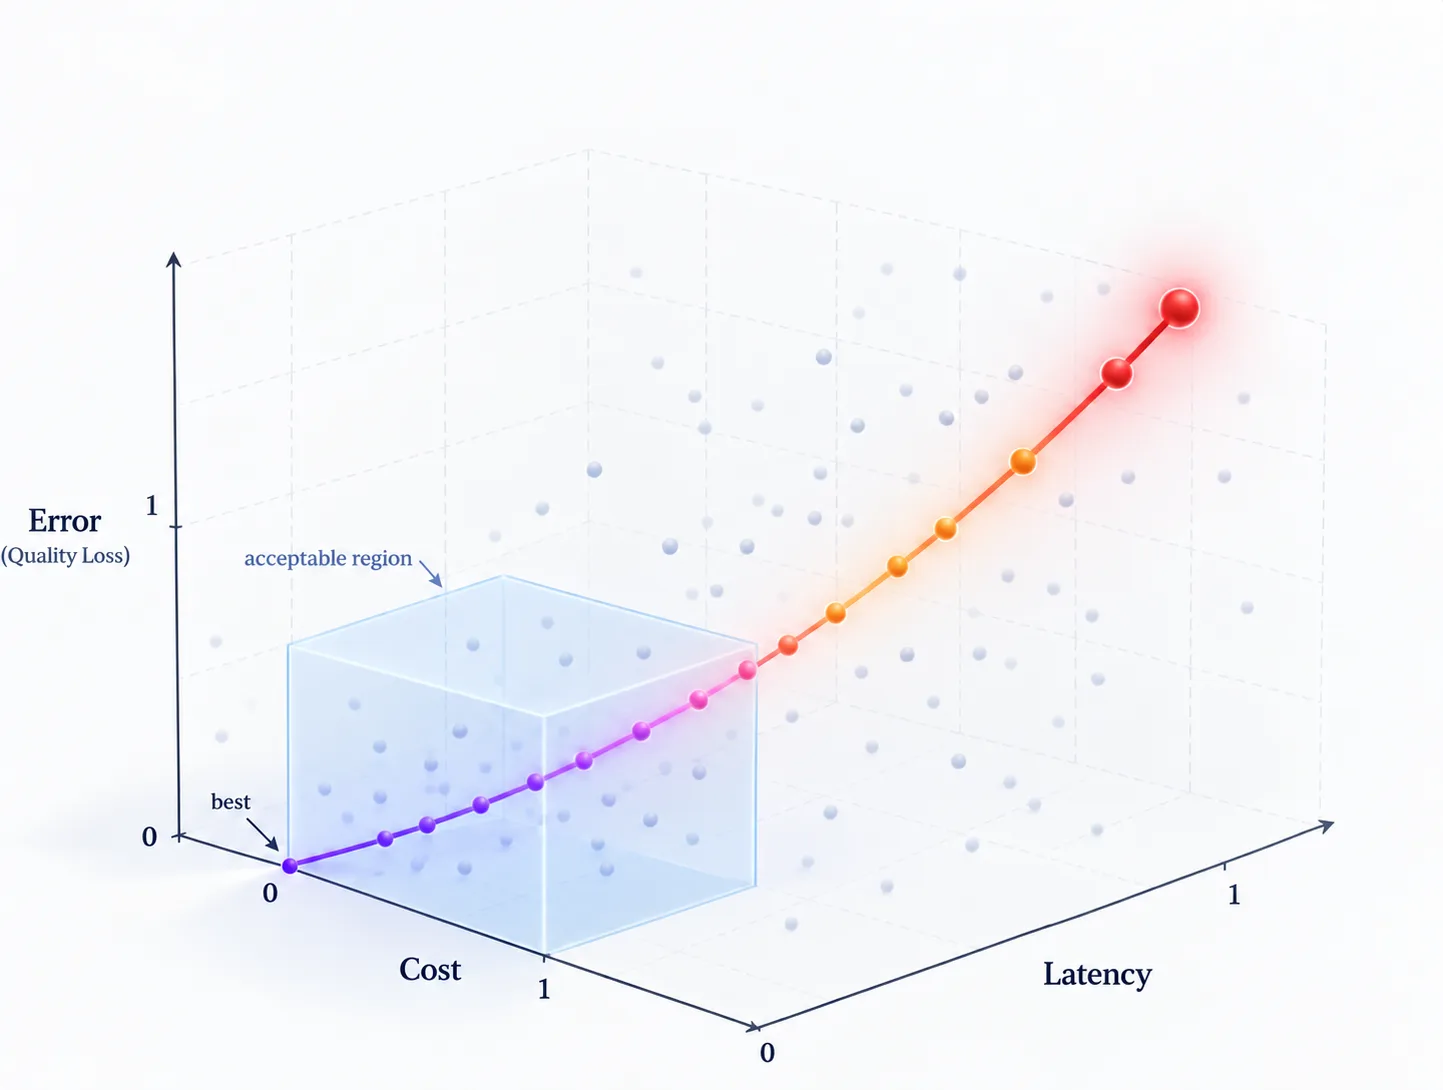
本文探讨生产环境智能体系统中的一个实际问题:如何将相互竞争的评估指标合并为单一且有意义的分数,以反映多个团队的目标。团队必须在准确性、成本、速度和可靠性之间取得平衡,而优化其中一个维度往往会损害另一个维度。
作者认为,大多数团队已经具备所需的基础要素,包括Jira工单、产品经理需求、财务预算、服务等级目标(SLO)、支持工单、轨迹记录和评估数据集。通常缺失的是业务目标与智能体配置决策之间的转换层。产品团队设定质量底线,财务团队设定成本上限,工程团队设定延迟和可靠性阈值,风险团队设定政策约束。随后,每种智能体配置都会根据同一个共享的框架进行评分。
忽视这一权衡的代价是可以衡量的。文章引用了CLEAR框架指出,准确性相近的智能体之间成本差异可达50倍,并且在单次运行中成功率为60%的智能体,在八次运行中衡量一致性时,成功率降至25%。这些发现来自一篇预印本论文,但作者表示,其趋势与许多团队在生产中观察到的情况相符。
核心原则是先将方案限定在框架之内,再在框架内进行优化。组件指标对于解释智能体失败的原因仍然必不可少,但单一的综合评分可以避免这样一种情况:某个模型在提升质量的同时使延迟超出客户可接受的范围,从而引发反复争论。文章用通俗的语言定义了这一框架,用约40行NumPy代码构建了评分函数,比较了两种示例配置,并展示了该评分如何接入LangSmith、Phoenix和DSPy等评估工具。
来源: Towards Data Science · 由HeadlinesBriefing整理摘要