
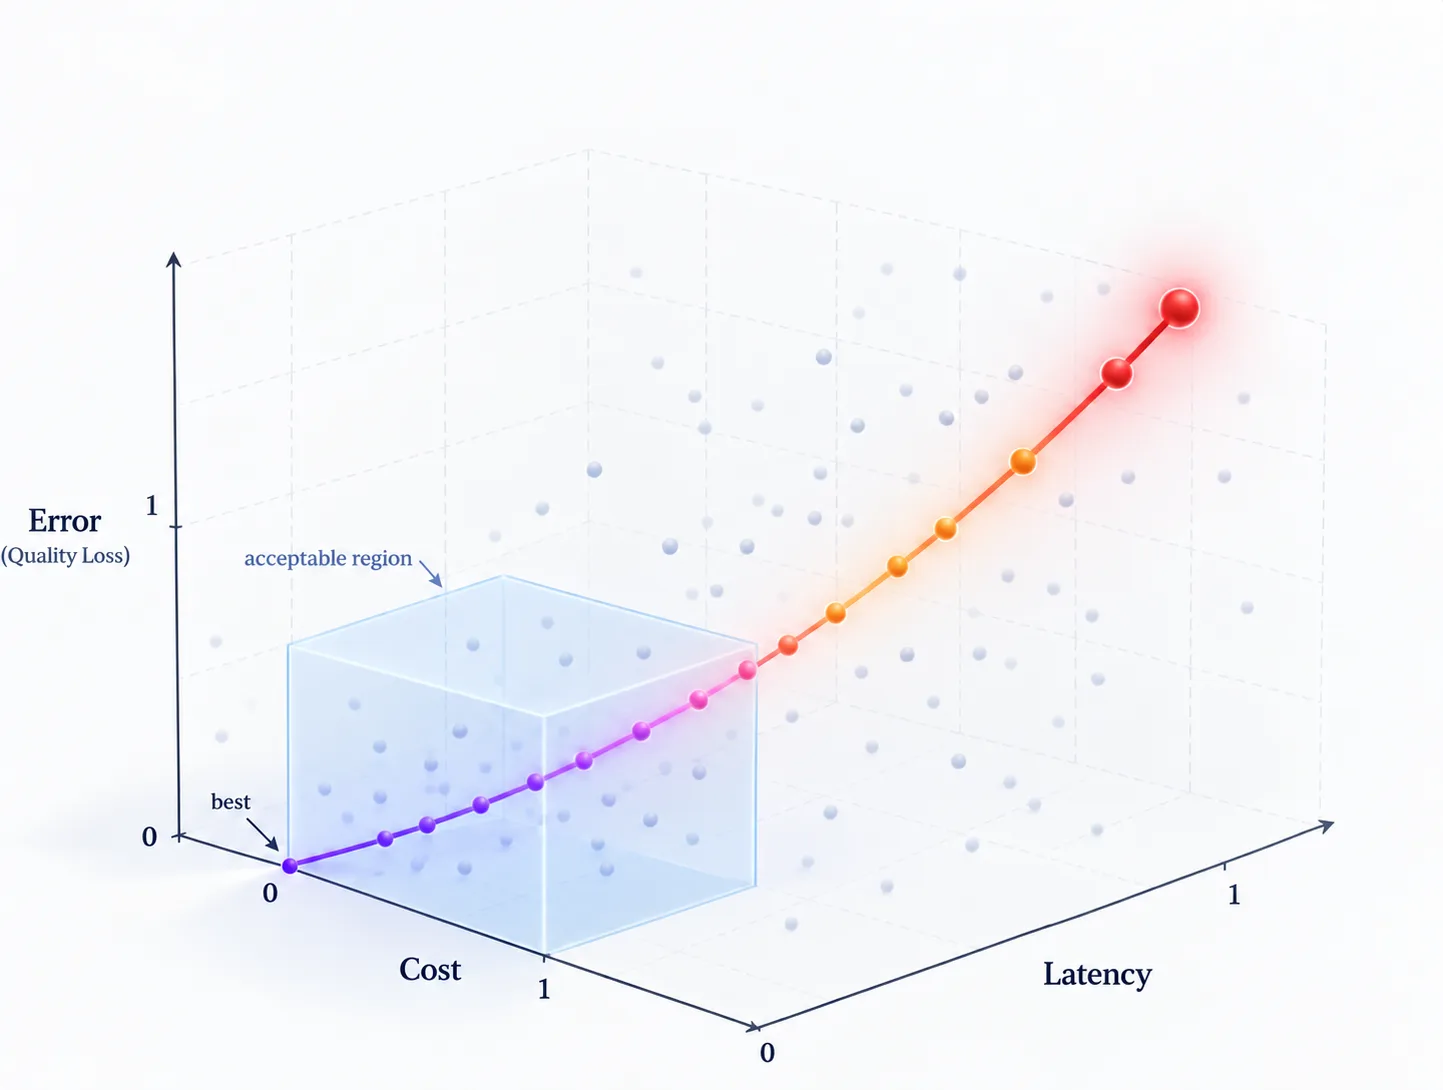
Dieser Artikel behandelt ein praktisches Problem produktiver Agentensysteme: die Zusammenführung konkurrierender Bewertungsmetriken zu einem einzigen, aussagekräftigen Wert, der die Ziele mehrerer Teams widerspiegelt. Teams müssen Genauigkeit, Kosten, Geschwindigkeit und Zuverlässigkeit ausbalancieren, und die Optimierung einer Dimension schadet oft einer anderen.
Der Autor argumentiert, dass die meisten Teams bereits über die nötigen Bausteine verfügen, darunter Jira-Tickets, PM-Anforderungen, Finanzbudgets, SLOs, Support-Tickets, Traces und Evaluationsdatensätze. Häufig fehlt jedoch eine Übersetzungsschicht zwischen den Geschäftszielen und den Entscheidungen zur Agentenkonfiguration. Das Produktteam legt Qualitätsuntergrenzen fest, die Finanzabteilung Kostenobergrenzen, die Technik Schwellenwerte für Latenz und Zuverlässigkeit und die Risikoabteilung Richtlinienvorgaben. Jede Agentenkonfiguration wird dann innerhalb desselben gemeinsamen Rahmens bewertet.
Die Kosten, diesen Zielkonflikt zu ignorieren, sind messbar. Unter Berufung auf das CLEAR-Framework stellt der Artikel fest, dass Agenten mit ähnlicher Genauigkeit sich in den Kosten um bis zu den 50-fachen unterscheiden können und dass die Erfolgsquote der Agenten von 60 % bei einem einzelnen Durchlauf auf 25 % sank, als die Konsistenz über acht Durchläufe gemessen wurde. Diese Befunde stammen aus einem einzigen Preprint, doch der Autor sagt, die Richtung stimme mit dem überein, was viele Teams im Produktivbetrieb beobachten.
Das zentrale Prinzip lautet, zuerst innerhalb des Rahmens zu bleiben und dann innerhalb dieses Rahmens zu optimieren. Komponentenmetriken bleiben notwendig, um zu erklären, warum ein Agent versagt hat, doch ein einziger zusammengesetzter Wert verhindert, dass ein Modell, das die Qualität verbessert, dabei aber die Latenz über die Geduldsgrenze der Kunden treibt, zu einer wiederkehrenden Debatte wird. Der Artikel definiert den Rahmen in einfacher Sprache, baut eine Bewertungsfunktion in etwa 40 Zeilen NumPy, vergleicht zwei Beispielkonfigurationen und zeigt, wie sich der Wert in Evaluationswerkzeuge wie LangSmith, Phoenix und DSPy einbinden lässt.
Quelle: Towards Data Science · Zusammengefasst von HeadlinesBriefing