
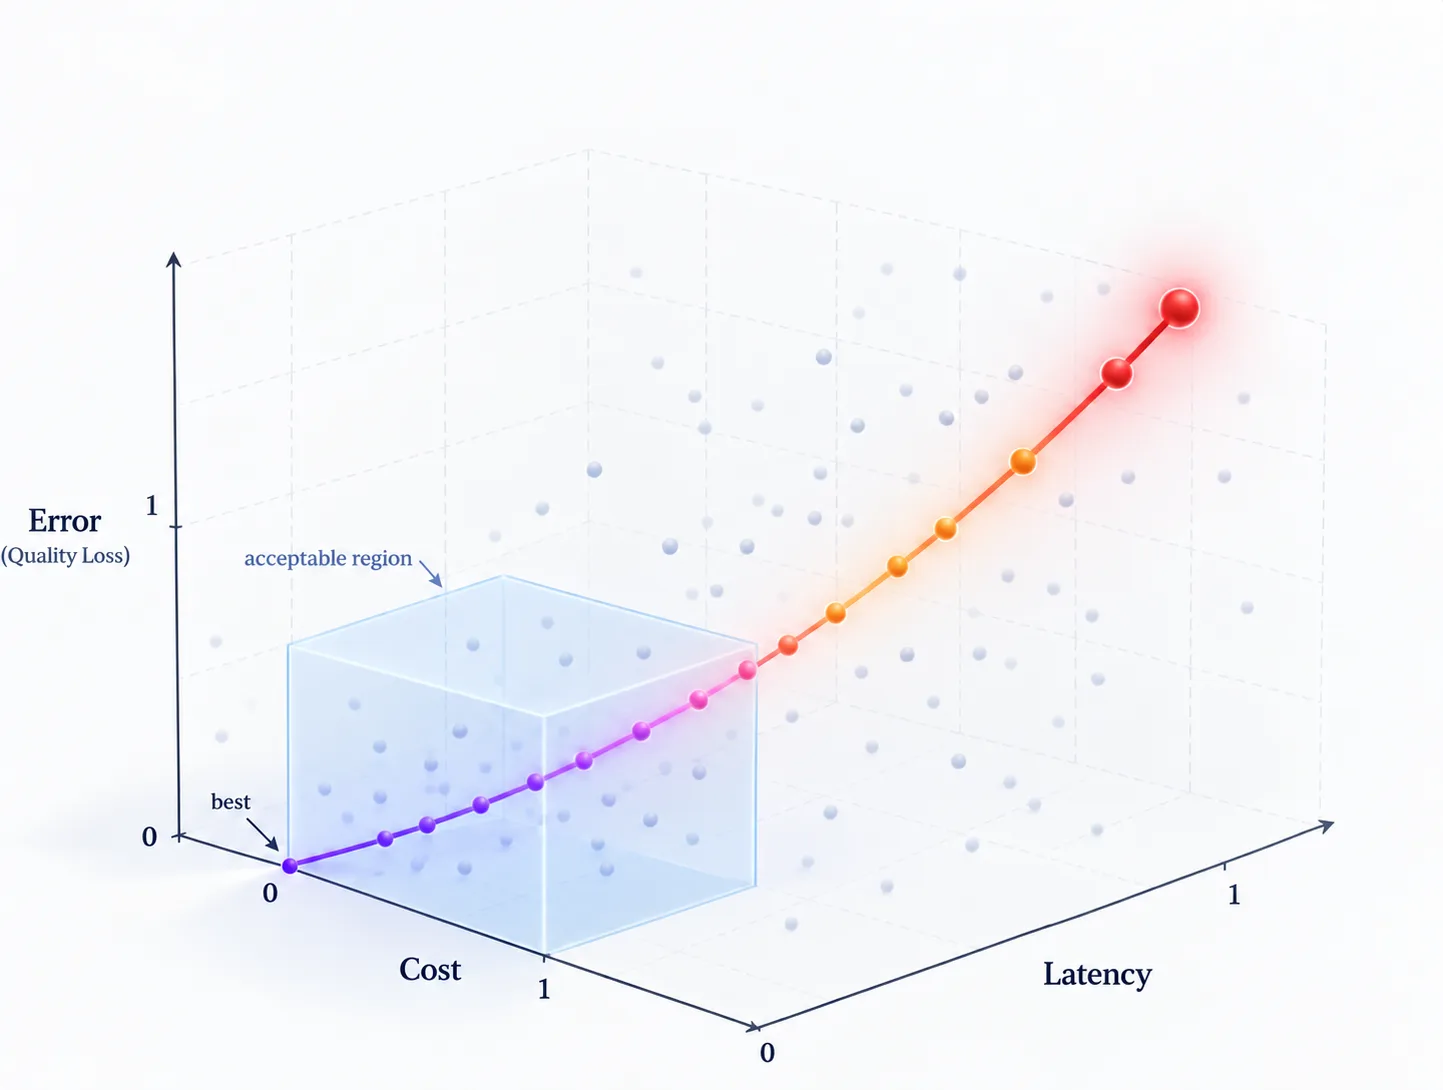
تتناول هذه المقالة مشكلة عملية في أنظمة الوكلاء الإنتاجية: دمج مقاييس التقييم المتنافسة في درجة واحدة ذات معنى تعكس أهداف فرق متعددة. يجب على الفرق موازنة الدقة والتكلفة والسرعة والموثوقية، وغالبًا ما يؤدي تحسين أحد هذه الأبعاد إلى الإضرار بغيره.
يرى المؤلف أن معظم الفرق تملك بالفعل المكونات اللازمة، ومنها تذاكر Jira ومتطلبات إدارة المنتج والميزانيات المالية واتفاقيات مستوى الخدمة وتذاكر الدعم والآثار ومجموعات بيانات التقييم. ما يغيب في أغلب الأحيان هو طبقة ترجمة بين الأهداف التجارية وقرارات إعداد الوكلاء. تحدد إدارة المنتج الحد الأدنى للجودة، وتحدد المالية سقوف التكلفة، وتحدد الهندسة عتبات الكمون والموثوقية، وتحدد المخاطر قيود السياسات. ثم تُقيَّم كل تهيئة للوكيل ضمن الإطار المشترك نفسه.
تكلفة تجاهل هذه المفاضلة قابلة للقياس. تستشهد المقالة بإطار CLEAR، وتشير إلى أن وكلاء بدقة متقاربة قد تختلف تكلفتهم بمقدار يصل إلى 50 ضعفًا، وأن نسبة نجاح الوكلاء انخفضت من 60% في تشغيل واحد إلى 25% عند قياس الاتساق عبر ثماني عمليات تشغيل. تستند هذه النتائج إلى ورقة بحثية أولية واحدة، لكن المؤلف يقول إن اتجاهها يطابق ما تراه فرق كثيرة في الإنتاج.
المبدأ الأساسي هو البقاء أولًا داخل الإطار ثم التحسين ضمنه. تظل المقاييس الجزئية ضرورية لتفسير سبب فشل الوكيل، لكن الدرجة المركبة الواحدة تمنع أن يتحول النموذج الذي يحسّن الجودة بينما يدفع الكمون إلى ما بعد حدود صبر العملاء إلى جدل متكرر. تعرّف المقالة الإطار بلغة بسيطة، وتبني دالة تقييم في نحو 40 سطرًا من NumPy، وتقارن بين تهيئتين نموذجيتين، وتوضح كيف يمكن ربط الدرجة بأدوات تقييم مثل LangSmith وPhoenix وDSPy.
المصدر: Towards Data Science · لخّصه HeadlinesBriefing