
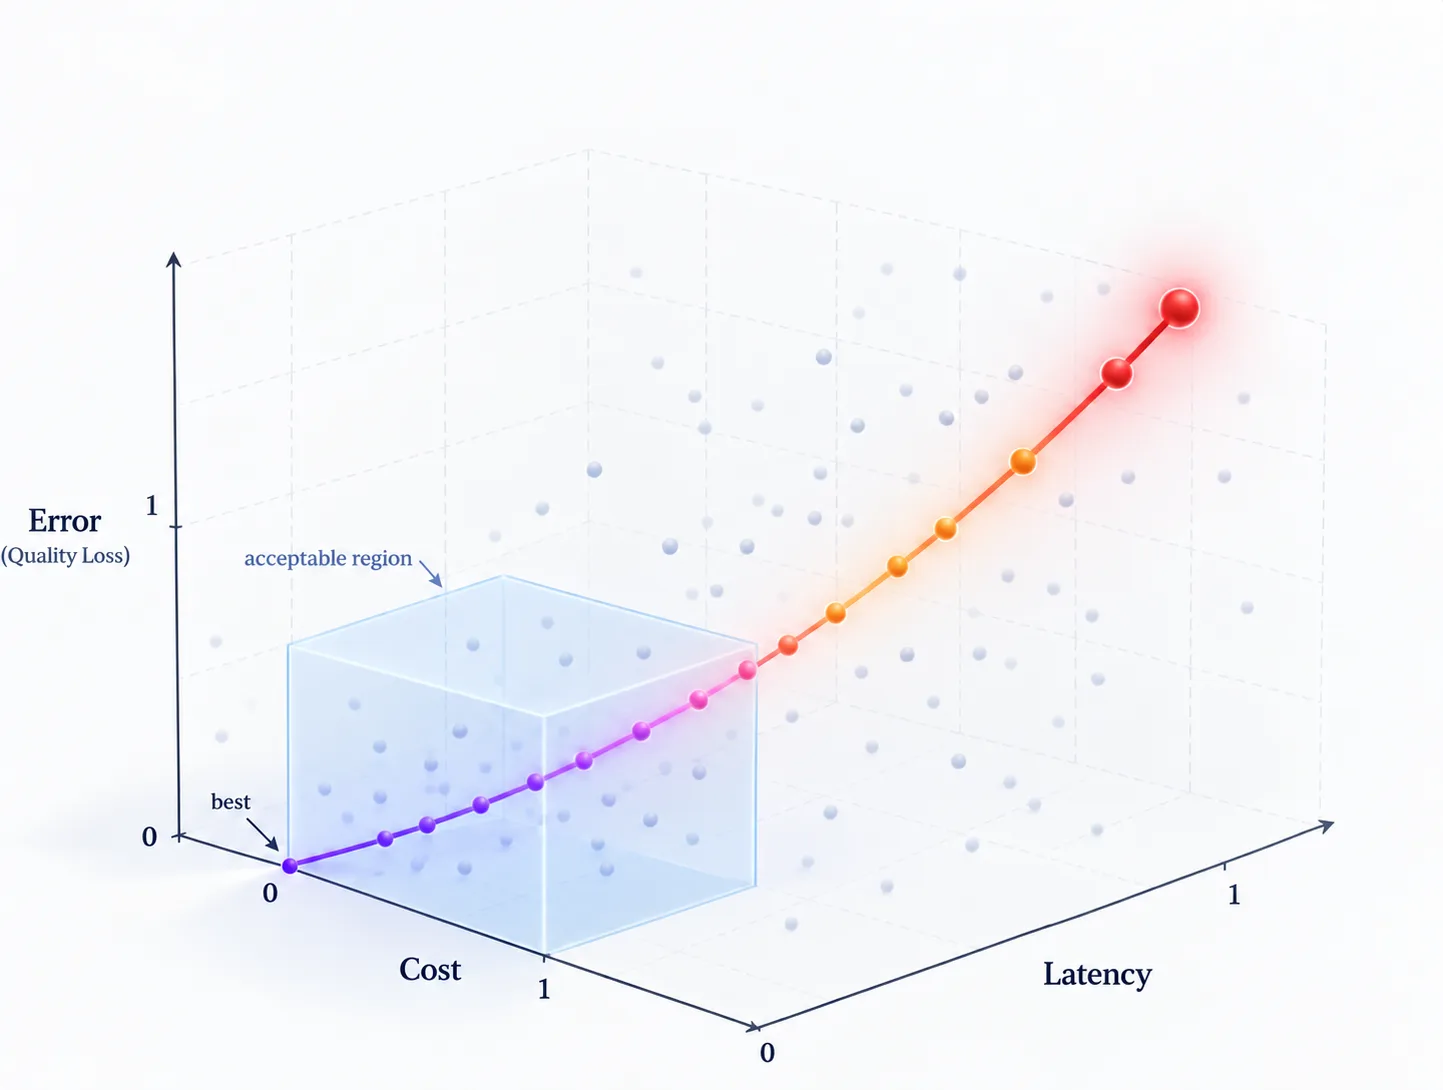
Cet article aborde un problème pratique des systèmes d'agents en production : fusionner des métriques d'évaluation concurrentes en un score unique et significatif, qui reflète les objectifs de plusieurs équipes. Les équipes doivent équilibrer la précision, le coût, la vitesse et la fiabilité, et optimiser une dimension nuit souvent à une autre.
L'auteur soutient que la plupart des équipes disposent déjà des ingrédients nécessaires, notamment des tickets Jira, des exigences produit, des budgets financiers, des SLO, des tickets de support, des traces et des jeux de données d'évaluation. Ce qui manque souvent, c'est une couche de traduction entre les objectifs métier et les décisions de configuration des agents. Le produit fixe les seuils de qualité minimaux, la finance fixe les plafonds de coût, l'ingénierie fixe les seuils de latence et de fiabilité, et les risques fixent les contraintes de politique. Chaque configuration d'agent est ensuite évaluée dans le même cadre commun.
Le coût de l'ignorance de ce compromis est mesurable. En citant le cadre CLEAR, l'article indique que des agents de précision similaire peuvent différer en coût jusqu'à 50 fois, et que le taux de réussite des agents est passé de 60 % sur une exécution unique à 25 % lorsque la cohérence est mesurée sur huit exécutions. Ces résultats proviennent d'une seule prépublication, mais l'auteur affirme que la tendance correspond à ce que de nombreuses équipes observent en production.
Le principe central consiste à rester d'abord à l'intérieur du cadre, puis à optimiser à l'intérieur de celui-ci. Les métriques par composant restent nécessaires pour expliquer les échecs d'un agent, mais un score composite unique évite qu'un modèle améliorant la qualité tout en poussant la latence au-delà de la patience des clients ne devienne un débat récurrent. L'article définit ce cadre en langage clair, construit une fonction de score en une quarantaine de lignes de NumPy, compare deux configurations types et montre comment le score peut s'intégrer à des outils d'évaluation tels que LangSmith, Phoenix et DSPy.
Source: Towards Data Science · Résumé par HeadlinesBriefing