
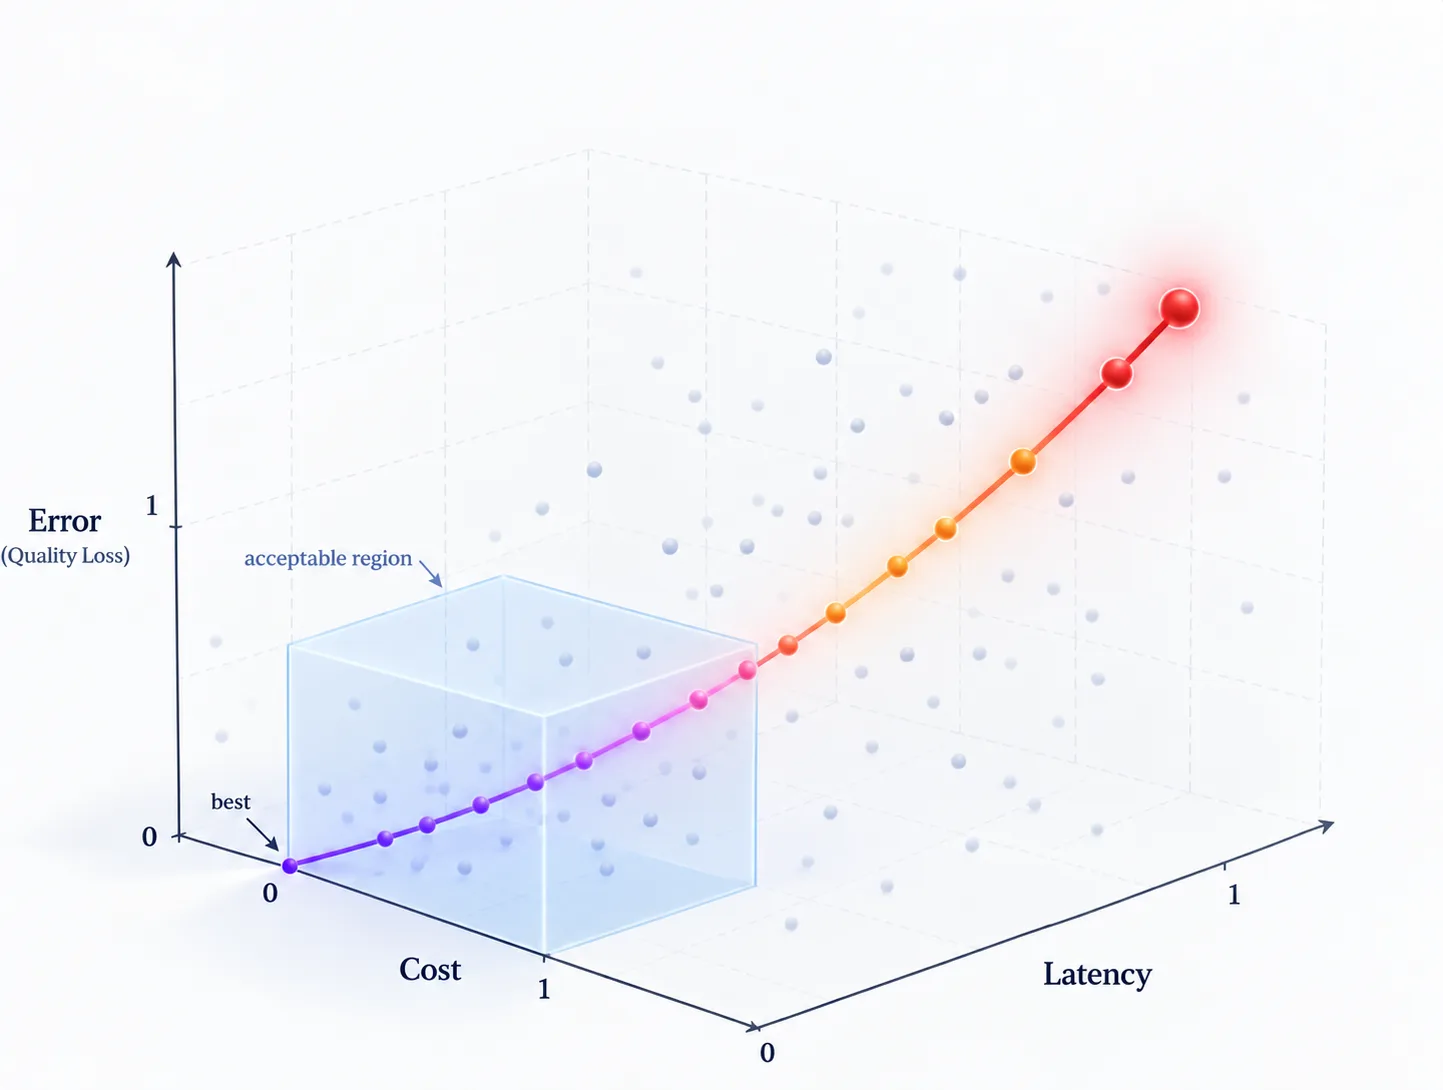
Este artículo aborda un problema práctico en los sistemas de agentes en producción: fusionar métricas de evaluación en conflicto en una única puntuación significativa que refleje los objetivos de varios equipos. Los equipos deben equilibrar la precisión, el costo, la velocidad y la fiabilidad, y optimizar una dimensión suele perjudicar a otra.
El autor sostiene que la mayoría de los equipos ya tienen los ingredientes, incluidos tickets de Jira, requisitos de producto, presupuestos financieros, SLO, tickets de soporte, trazas y conjuntos de datos de evaluación. Lo que suele faltar es una capa de traducción entre los objetivos de negocio y las decisiones de configuración del agente. Producto fija los niveles mínimos de calidad, finanzas fija los techos de costo, ingeniería fija los umbrales de latencia y fiabilidad, y riesgo fija las restricciones de política. Cada configuración del agente se puntúa entonces dentro de la misma caja compartida.
El costo de ignorar esta compensación es medible. Citando el marco CLEAR, el artículo señala que agentes con una precisión similar pueden diferir en costo hasta 50 veces, y que el éxito de los agentes bajó del 60% en una sola ejecución al 25% cuando se midió la consistencia a lo largo de ocho ejecuciones. Estos hallazgos provienen de un único preprint, pero el autor afirma que la tendencia coincide con lo que muchos equipos observan en producción.
El principio central es permanecer primero dentro de la caja y optimizar después dentro de ella. Las métricas de componentes siguen siendo necesarias para explicar por qué falló un agente, pero una única puntuación compuesta evita que un modelo que mejora la calidad mientras empuja la latencia más allá de los límites de paciencia del cliente se convierta en un debate repetido. El artículo define la caja en lenguaje sencillo, construye una función de puntuación en unas 40 líneas de NumPy, compara dos configuraciones de ejemplo y muestra cómo la puntuación puede integrarse en herramientas de evaluación como LangSmith, Phoenix y DSPy.
Fuente: Towards Data Science · Resumido por HeadlinesBriefing