
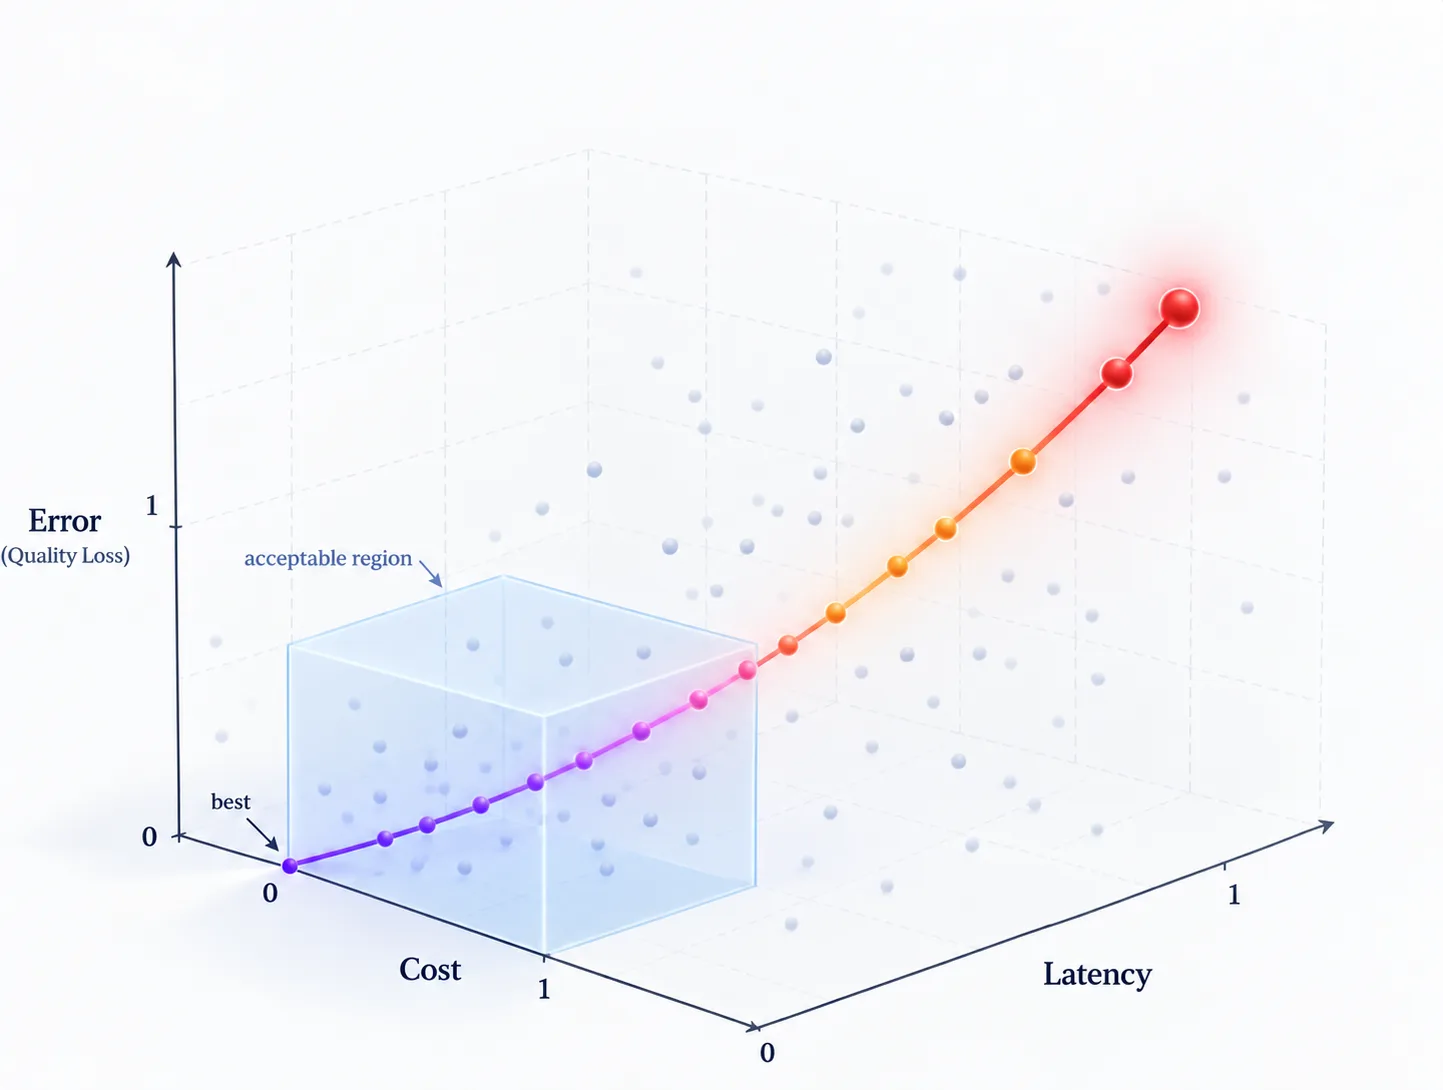
এই নিবন্ধটি উৎপাদন এজেন্ট সিস্টেমের একটি ব্যবহারিক সমস্যা নিয়ে আলোচনা করে: পরস্পরবিরোধী মূল্যায়ন মেট্রিকগুলোকে একটি একক, অর্থবহ স্কোরে একীভূত করা, যা একাধিক দলের লক্ষ্যকে প্রতিফলিত করে। দলগুলোকে নির্ভুলতা, খরচ, গতি ও নির্ভরযোগ্যতার মধ্যে ভারসাম্য রাখতে হয়, এবং একটি মাত্রাকে অপ্টিমাইজ করলে প্রায়ই অন্যটির ক্ষতি হয়।
লেখক যুক্তি দেন যে বেশিরভাগ দলের কাছে ইতোমধ্যেই প্রয়োজনীয় উপাদান রয়েছে, যার মধ্যে আছে Jira টিকিট, PM প্রয়োজনীয়তা, অর্থায়ন বাজেট, SLO, সাপোর্ট টিকিট, ট্রেস এবং মূল্যায়ন ডেটাসেট। যা প্রায়ই অনুপস্থিত থাকে তা হলো ব্যবসায়িক লক্ষ্য এবং এজেন্ট কনফিগারেশন সিদ্ধান্তের মধ্যে একটি অনুবাদ স্তর। প্রোডাক্ট মানের নিম্নসীমা ঠিক করে, ফাইন্যান্স খরচের উর্ধ্বসীমা ঠিক করে, ইঞ্জিনিয়ারিং লেটেন্সি ও নির্ভরযোগ্যতার সীমা ঠিক করে, এবং রিস্ক নীতিগত সীমাবদ্ধতা ঠিক করে। এরপর প্রতিটি এজেন্ট কনফিগারেশনকে একই যৌথ কাঠামোর ভিত্তিতে স্কোর করা হয়।
এই ট্রেড-অফ উপেক্ষা করার মূল্য পরিমাপযোগ্য। CLEAR ফ্রেমওয়ার্ক উদ্ধৃত করে নিবন্ধটি উল্লেখ করে যে একই রকম নির্ভুলতার এজেন্টগুলোর খরচে ৫০ গুণ পর্যন্ত পার্থক্য হতে পারে, এবং আট বার চালিয়ে ধারাবাহিকতা মাপলে এজেন্টের সাফল্যের হার একবারের ৬০% থেকে ২৫%-এ নেমে আসে। এই ফলাফলগুলো একটি মাত্র প্রিপ্রিন্ট থেকে এসেছে, তবে লেখক বলেন এর প্রবণতা অনেক দল উৎপাদনে যা দেখে তার সঙ্গে মেলে।
মূল নীতি হলো প্রথমে কাঠামোর ভেতরে থাকা, তারপর তার মধ্যে অপ্টিমাইজ করা। এজেন্ট কেন ব্যর্থ হলো তা ব্যাখ্যা করতে উপাদান-মেট্রিক এখনও প্রয়োজন, তবে একটিমাত্র সমন্বিত স্কোর এমন একটি মডেলকে ঘিরে বারবার বিতর্ক ঠেকায়, যা মান উন্নত করলেও লেটেন্সি গ্রাহকের ধৈর্যের সীমা ছাড়িয়ে দেয়। নিবন্ধটি সহজ ভাষায় কাঠামোটি সংজ্ঞায়িত করে, প্রায় ৪০ লাইনের NumPy-তে একটি স্কোরিং ফাংশন তৈরি করে, দুটি নমুনা কনফিগারেশন তুলনা করে, এবং দেখায় কীভাবে এই স্কোর LangSmith, Phoenix ও DSPy-এর মতো মূল্যায়ন টুলে যুক্ত করা যায়।
উৎস: Towards Data Science · সারাংশ: HeadlinesBriefing