
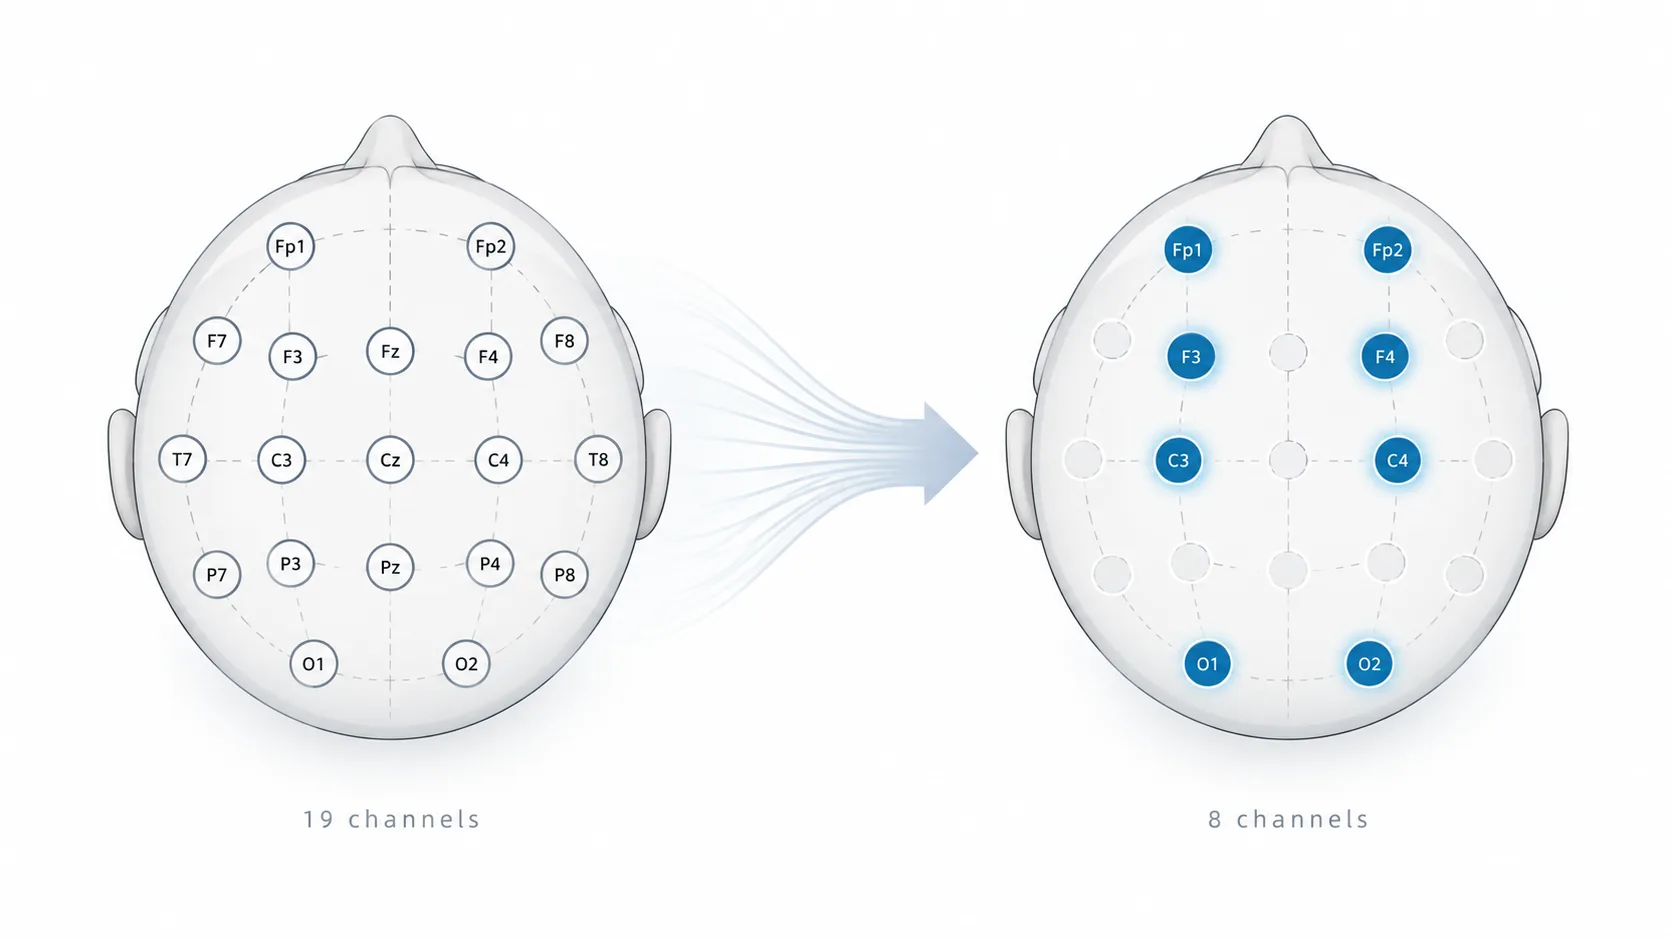
機械学習のパイプラインでは、測定が多いほど結果が良くなると想定されがちですが、センサーベースのシステムでは、EEGチャンネルを一つ追加するごとに、電極、信号ストリーム、セットアップの複雑さ、処理コストが増えます。本分析では、公開されている暗算データセットの頭皮EEG 19チャンネルすべてが被験者間の分類に必要かを検証しました。同じ前処理、スペクトル特徴、モデルの系統、被験者を除外した評価を維持したまま、電極配置を12、8、4、2、1チャンネルに減らしました。
PhysioNetのEEGMATデータセットには36名の被験者が含まれており、それぞれにベースラインの記録と、連続した暗算中の記録があります。分類の対象は記録条件であり、認知負荷を普遍的に検証した指標ではありません。信号は1〜40 Hzでフィルタリングされ、4秒の窓に分割されました。シータ、アルファ、ベータ、低ガンマの各帯域で相対パワーを計算し、2,134窓から窓ごとに76の特徴量が得られました。
チャンネル数を大幅に減らしても、未知の被験者に対する性能の変化はわずかでした。さらに示唆的だったのは、いくつかの電極がほぼすべての学習フォールドで上位にランクされたにもかかわらず、被験者を除外した評価では、ランダムに選んだチャンネルの組み合わせを上回らなかった点です。そのため、本研究は最適なEEG配置を見つけることから、より広い教訓へと焦点が移りました。安定した特徴量の重要度は、サンプル外での有用性が高いことを必ずしも意味しないということです。
この研究は、検証方法が報告される性能を大きく左右するという先行研究の知見に基づいています。個々の窓ではなく被験者全体を除外することで、モデルが一度も見たことのない人々に対してどのように振る舞うかをより現実的に把握できます。これは実用的な導入にとって中心的な要件です。
出典: Towards Data Science · 要約:HeadlinesBriefing