
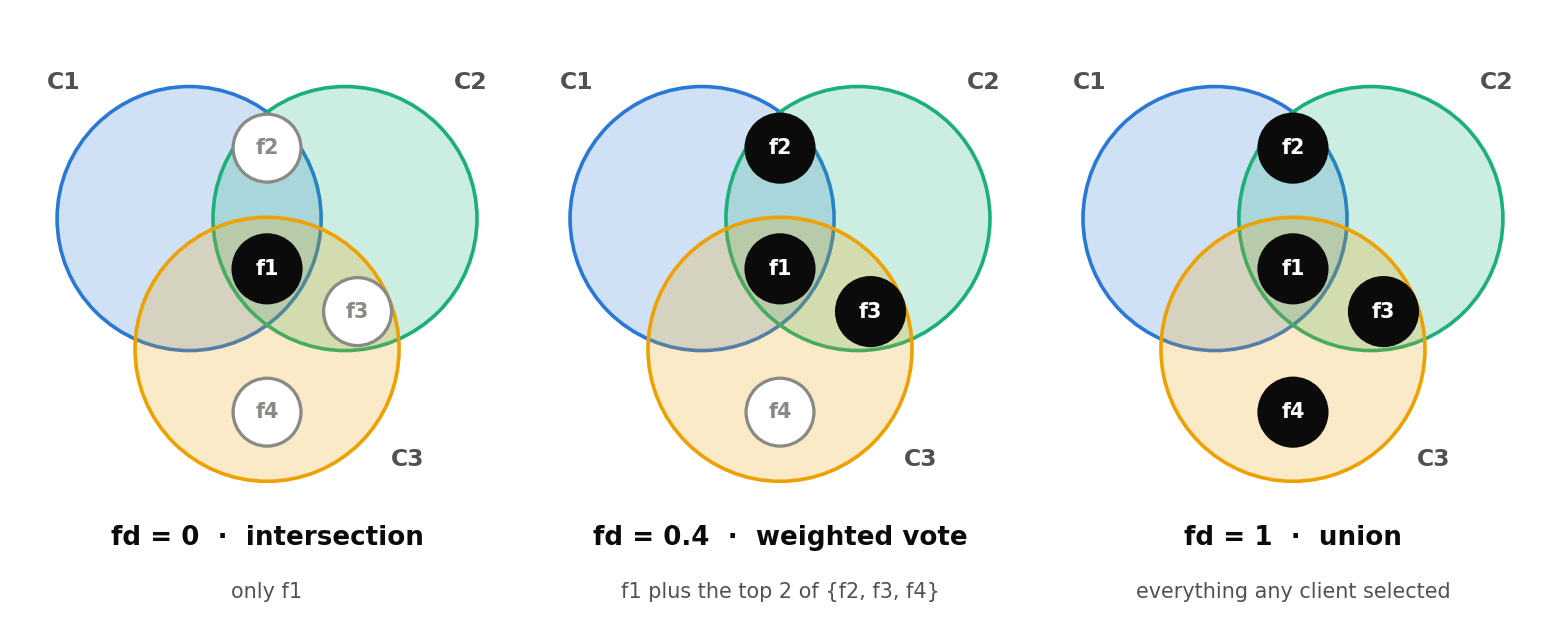
病院、銀行、エッジデバイスは、同じスキーマを持つ表データを用いて一つのモデルを共同で学習したいと考えることが多いものの、行データは非公開に保つ必要があります。このような水平連合学習は、一般に各拠点の重みを平均するFed Avgに依存しています。Fed Avgはどの特徴量をモデルに含めるべきかを一切判断しないため、無関係な列はすべての更新で引き継がれ、小規模な拠点ほど強く感じるノイズを加えてしまいます。
この課題の解決のために開発されたFeature Electionは、連合型特徴量選択の多くの研究よりも必要とする仕組みが少ない手法です。新しい専用アルゴリズムを採用する代わりに、各拠点は信頼している通常の選択器(Lasso、ランダムフォレストの重要度、相互情報量など)を保持し、自拠点の行データに対して実行して投票を送信します。各拠点は、残した特徴量の二値マスク、選好スコアのベクトル、サンプル数を送ります。選出の過程で行データや勾配が拠点から出ることはありません。
サーバーは、すべての拠点が選んだ特徴量を残し、どの拠点も選ばなかった特徴量を除外します。意見が分かれた特徴量は拠点規模で重み付けされた投票にかけられ、「自由度」と呼ばれる調整可能なパラメータが、そのうちいくつをモデルに組み込むかを決めます。その後、各拠点は得られたグローバルマスクを自身の列に適用し、縮小された表に対して通常の連合学習を実行します。
この手法はNumPyで実装され、NVIDIA FLAREのジョブとして示されています。Flower向けのコードも併せて掲載されています。
出典: Towards Data Science · 要約:HeadlinesBriefing