
Больницы, банки и периферийные устройства часто хотят совместно обучить одну модель, но их таблицы имеют общую схему, тогда как строки должны оставаться приватными. Такая постановка, горизонтальное федеративное обучение, обычно опирается на Fed Avg, который усредняет веса с каждого участка. Fed Avg никогда не спрашивает, какие признаки должны войти в модель, поэтому каждый нерелевантный столбец переносится через все обновления и добавляет шум, который сильнее всего ощущают небольшие участки.
Feature Election, метод, разработанный для восполнения этого пробела, требует меньше, чем большинство исследований федеративного отбора признаков. Вместо нового специализированного алгоритма каждый участок сохраняет обычный селектор, которому доверяет, например Lasso, важности случайного леса или взаимную информацию, запускает его на своих строках и отправляет голос. Каждый участок передает бинарную маску отобранных признаков, вектор оценок предпочтения и количество образцов. Во время голосования строки данных и градиенты с участка не покидают его.
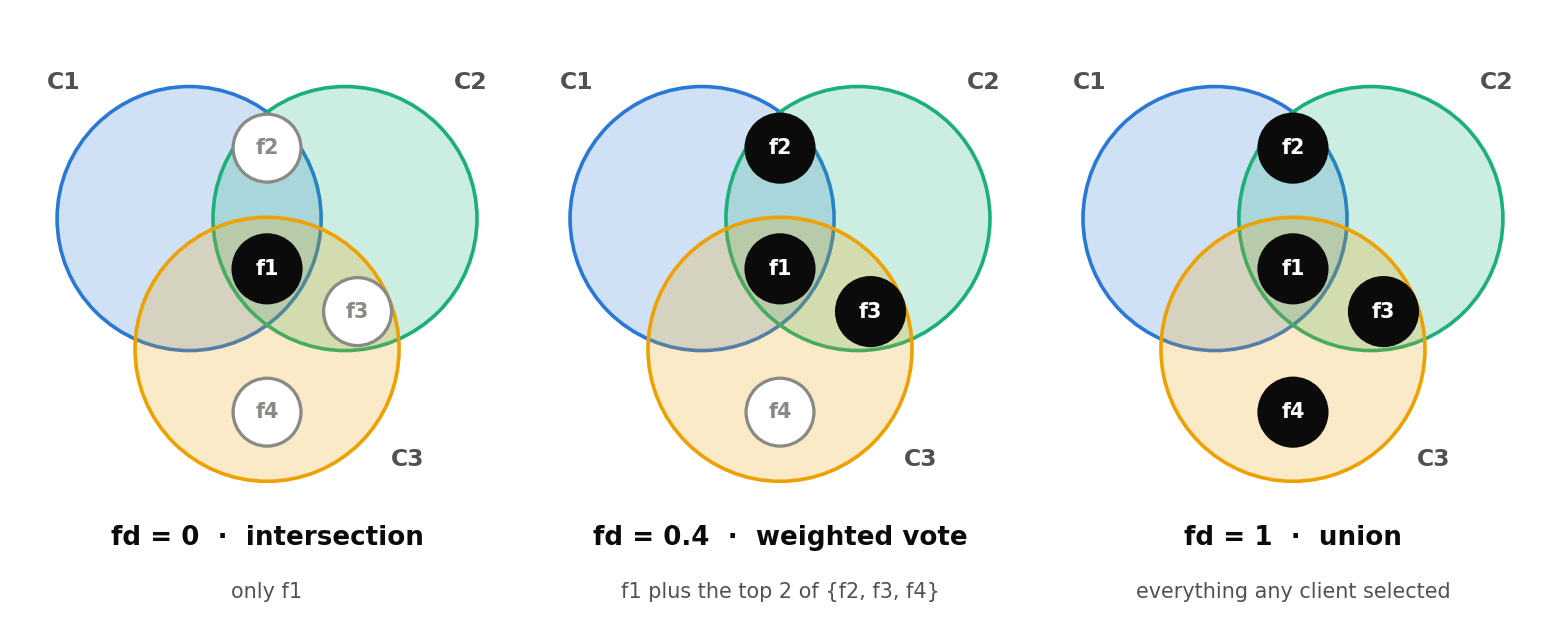
Сервер сохраняет признаки, которые выбрали все участки, и отбрасывает те, которые не выбрал ни один. Спорные признаки передаются на голосование, взвешенное по размеру участка, а один настраиваемый параметр, называемый степенью свободы, определяет, сколько из них войдут в модель. Затем каждый участок применяет полученную глобальную маску к своим столбцам, и обычное федеративное обучение выполняется на сокращенной таблице.
Подход реализован на NumPy и продемонстрирован как задание в NVIDIA FLARE, также приведен код для Flower.
Источник: Towards Data Science · Сводку подготовил HeadlinesBriefing