
医院、银行和边缘设备通常希望共同训练一个模型,但它们的表格结构相同,行数据却必须保持私密。这种场景即水平联邦学习,通常依赖于 Fed Avg,即对各站点的权重进行平均。Fed Avg 从不询问哪些特征应当纳入模型,因此每一个无关的列都会在每次更新中被携带,并增加噪声,而规模较小的站点受其影响最大。
特征选举是为填补这一空白而开发的方法,其所需的条件比大多数联邦特征选择研究都要少。它不采用全新的专用算法,而是让每个站点保留其已经信赖的常规选择器,例如 Lasso、随机森林重要性或互信息,在自身的行数据上运行,并发送一张投票。每个站点发送保留特征的二进制掩码、偏好分数向量及其样本数。在选举期间,没有任何行数据或梯度离开站点。
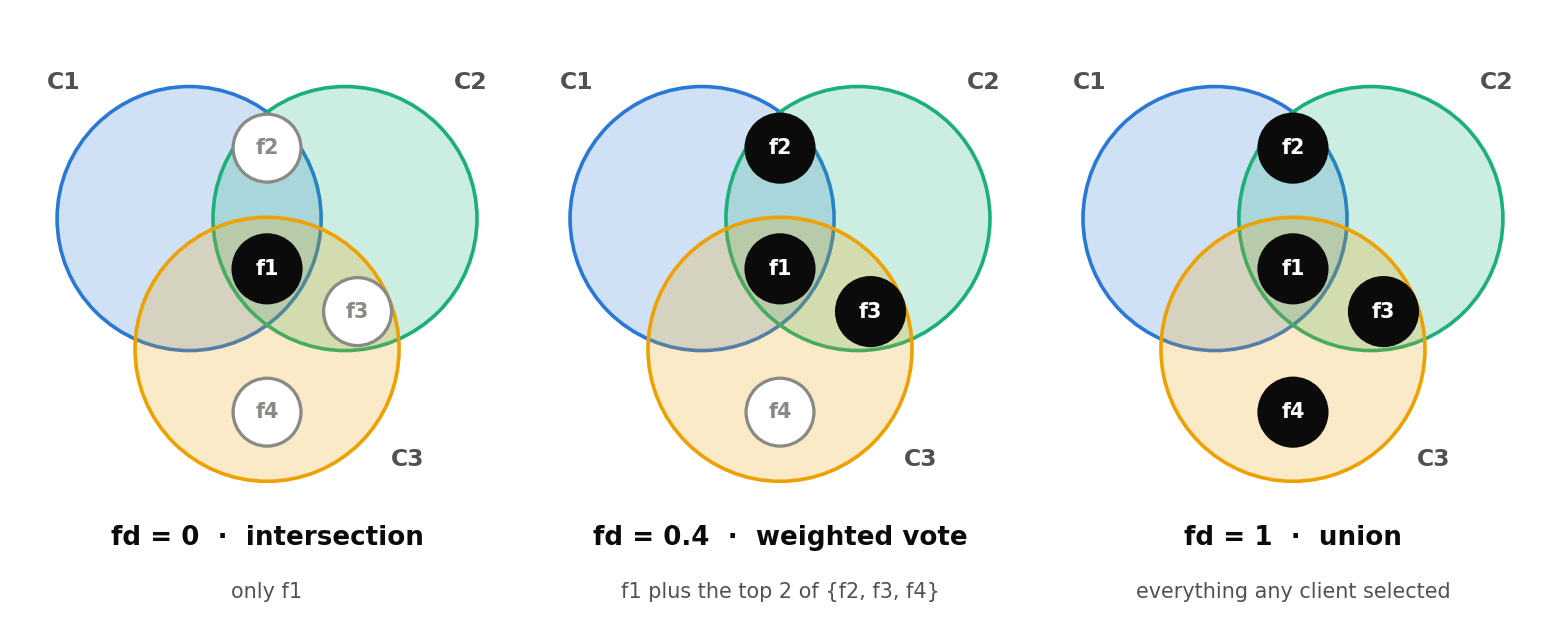
服务器保留所有站点都选中的特征,并丢弃没有任何站点选中的特征。存在争议的特征则进入按站点规模加权的投票,一个名为“自由度”的可调参数决定其中有多少特征进入模型。随后,每个站点将得到的全局掩码应用于其各列,并在缩减后的表格上运行常规的联邦训练。
该方法已在 NumPy 中实现,并在 NVIDIA FLARE 中作为一项任务进行了演示,同时也展示了 Flower 的代码。
来源: Towards Data Science · 由HeadlinesBriefing整理摘要