
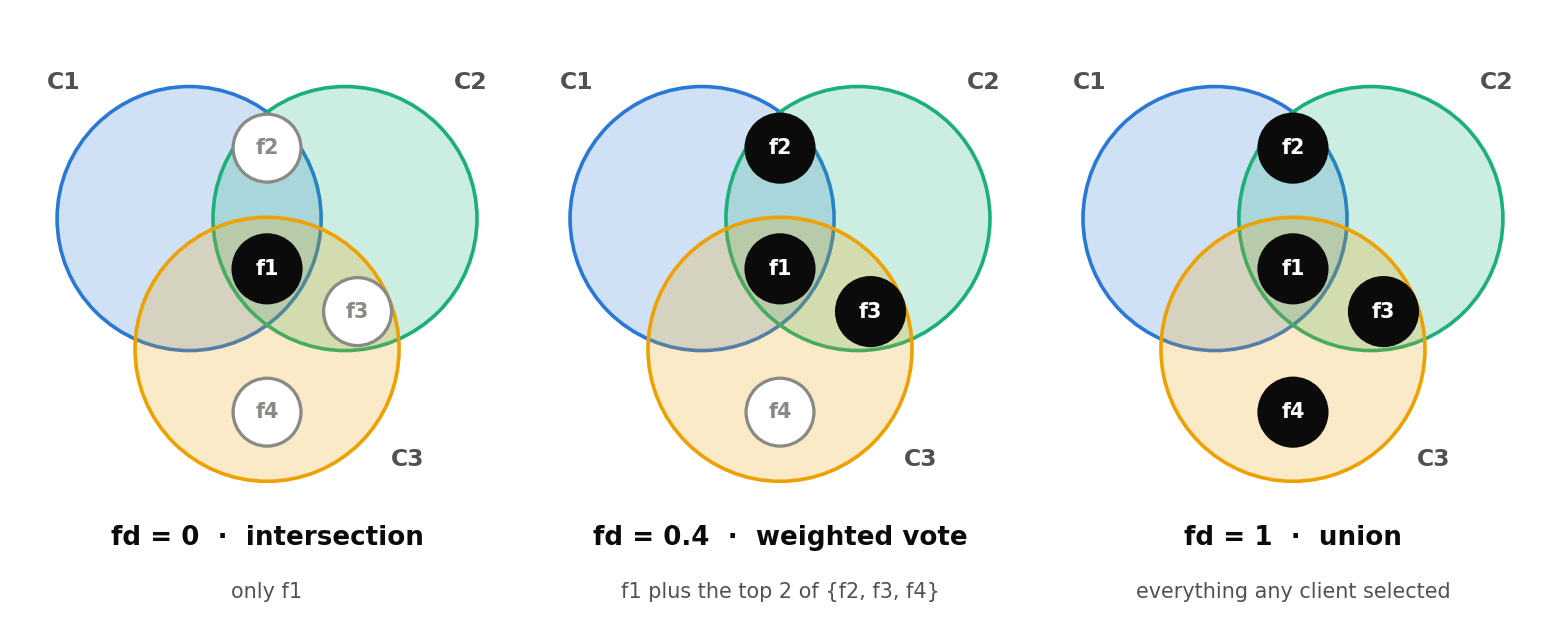
Les hôpitaux, les banques et les appareils en périphérie souhaitent souvent entraîner ensemble un même modèle, mais leurs tables partagent un schéma tandis que leurs lignes doivent rester privées. Ce cadre, l'apprentissage fédéré horizontal, repose généralement sur Fed Avg, qui moyenne les poids de chaque site. Fed Avg ne se demande jamais quelles variables doivent figurer dans le modèle : chaque colonne non pertinente est donc transportée à chaque mise à jour et ajoute du bruit, ressenti surtout par les plus petits sites.
Feature Election, une méthode conçue pour combler ce manque, demande moins que la plupart des travaux de recherche sur la sélection fédérée de variables. Plutôt que d'adopter un algorithme nouveau et dédié, chaque site conserve le sélecteur ordinaire auquel il fait confiance, comme Lasso, les importances de forêt aléatoire ou l'information mutuelle, l'exécute sur ses propres lignes et envoie un vote. Chaque site transmet un masque binaire des variables retenues, un vecteur de scores de préférence et son nombre d'échantillons. Aucune ligne ni aucun gradient ne quitte le site pendant l'élection.
Le serveur conserve les variables que tous les sites ont sélectionnées et écarte celles qu'aucun site n'a retenues. Les variables contestées sont soumises à un vote pondéré par la taille des sites, et un paramètre ajustable appelé degré de liberté détermine combien d'entre elles entrent dans le modèle. Chaque site applique ensuite le masque global obtenu à ses colonnes, et l'entraînement fédéré classique s'exécute sur la table réduite.
L'approche est implémentée en NumPy et présentée comme une tâche dans NVIDIA FLARE, avec également du code pour Flower.
Source: Towards Data Science · Résumé par HeadlinesBriefing