
Hospitales, bancos y dispositivos de borde suelen querer entrenar juntos un modelo, pero sus tablas comparten un esquema mientras que sus filas deben permanecer privadas. Este escenario, el aprendizaje federado horizontal, suele apoyarse en Fed Avg, que promedia los pesos de cada sitio. Fed Avg nunca pregunta qué características deben formar parte del modelo, así que cada columna irrelevante se arrastra en cada actualización y añade ruido que más sienten los sitios más pequeños.
Feature Election, un método desarrollado para cubrir esta brecha, pide menos que la mayoría de las investigaciones sobre selección federada de características. En lugar de adoptar un algoritmo nuevo y específico, cada sitio conserva el selector habitual en el que ya confía, como Lasso, las importancias de un bosque aleatorio o la información mutua, lo ejecuta sobre sus propias filas y envía un voto. Cada sitio envía una máscara binaria de las características conservadas, un vector de puntuaciones de preferencia y su número de muestras. Durante la elección no sale del sitio ninguna fila ni gradiente.
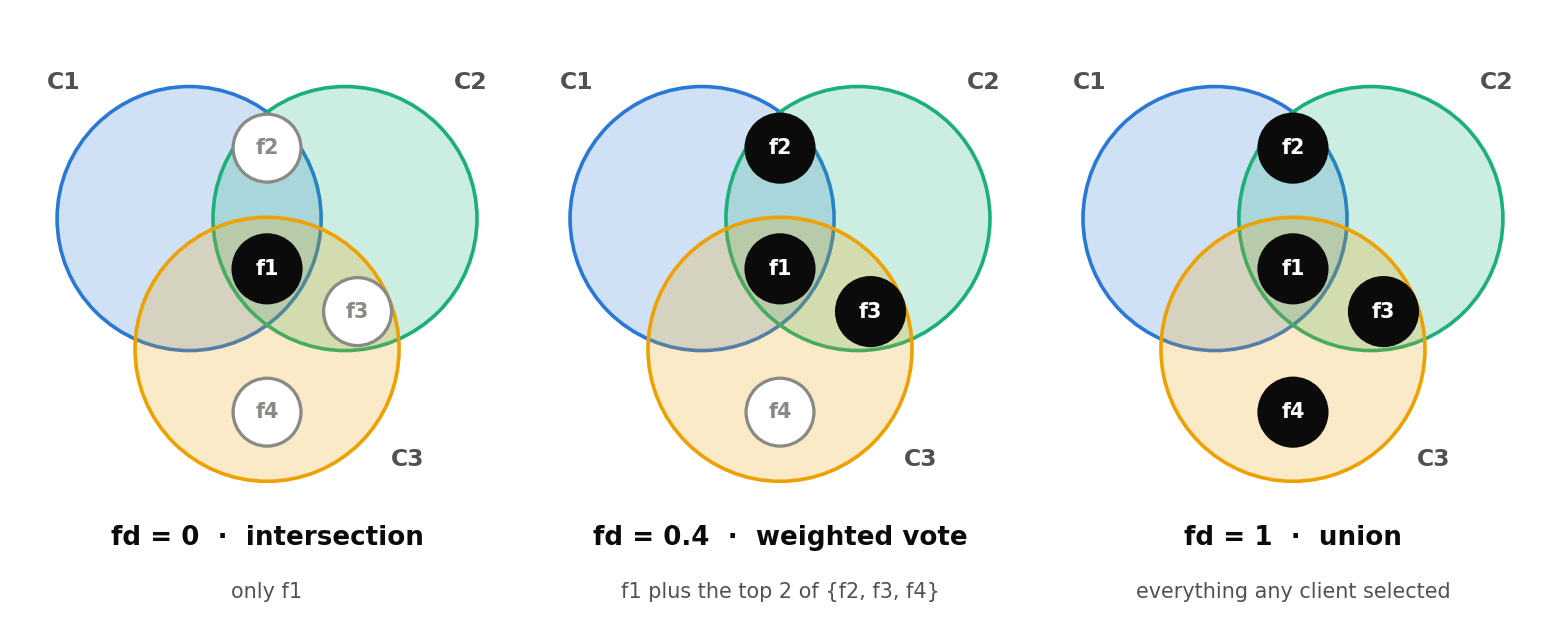
El servidor conserva las características que todos los sitios seleccionaron y descarta las que ningún sitio seleccionó. Las características disputadas pasan a una votación ponderada por el tamaño de cada sitio, y un único parámetro ajustable llamado grado de libertad decide cuántas de ellas entran en el modelo. Después, cada sitio aplica la máscara global resultante a sus columnas y se ejecuta el entrenamiento federado habitual sobre la tabla reducida.
El enfoque está implementado en NumPy y se demuestra como un trabajo en NVIDIA FLARE, con código también mostrado para Flower.
Fuente: Towards Data Science · Resumido por HeadlinesBriefing