
अस्पताल, बैंक और एज डिवाइस अक्सर एक साथ एक मॉडल प्रशिक्षित करना चाहते हैं, लेकिन उनकी तालिकाओं का स्कीमा एक जैसा होता है जबकि उनकी पंक्तियाँ निजी रहनी चाहिए। इस स्थिति को हॉरिजॉन्टल फेडरेटेड लर्निंग कहा जाता है, और यह आम तौर पर Fed Avg पर निर्भर करती है, जो हर साइट के वज़न का औसत निकालती है। Fed Avg कभी यह नहीं पूछता कि मॉडल में कौन-से फीचर होने चाहिए, इसलिए हर अप्रासंगिक कॉलम हर अपडेट में आगे बढ़ता रहता है और शोर जोड़ता है, जिसे छोटी साइटें सबसे ज़्यादा महसूस करती हैं।
इस कमी को दूर करने के लिए विकसित फीचर इलेक्शन विधि फेडरेटेड फीचर चयन के अधिकांश शोध की तुलना में कम माँगती है। किसी नए विशेष एल्गोरिदम को अपनाने के बजाय, हर साइट अपना पहले से भरोसेमंद सामान्य सेलेक्टर रखती है, जैसे Lasso, रैंडम फ़ॉरेस्ट इम्पोर्टेंस या म्यूचुअल इन्फॉर्मेशन, उसे अपनी पंक्तियों पर चलाती है और एक वोट भेजती है। हर साइट चुने गए फीचर का बाइनरी मास्क, प्राथमिकता स्कोर का वेक्टर और अपनी नमूना संख्या भेजती है। चुनाव के दौरान कोई पंक्ति या ग्रेडिएंट साइट से बाहर नहीं जाता।
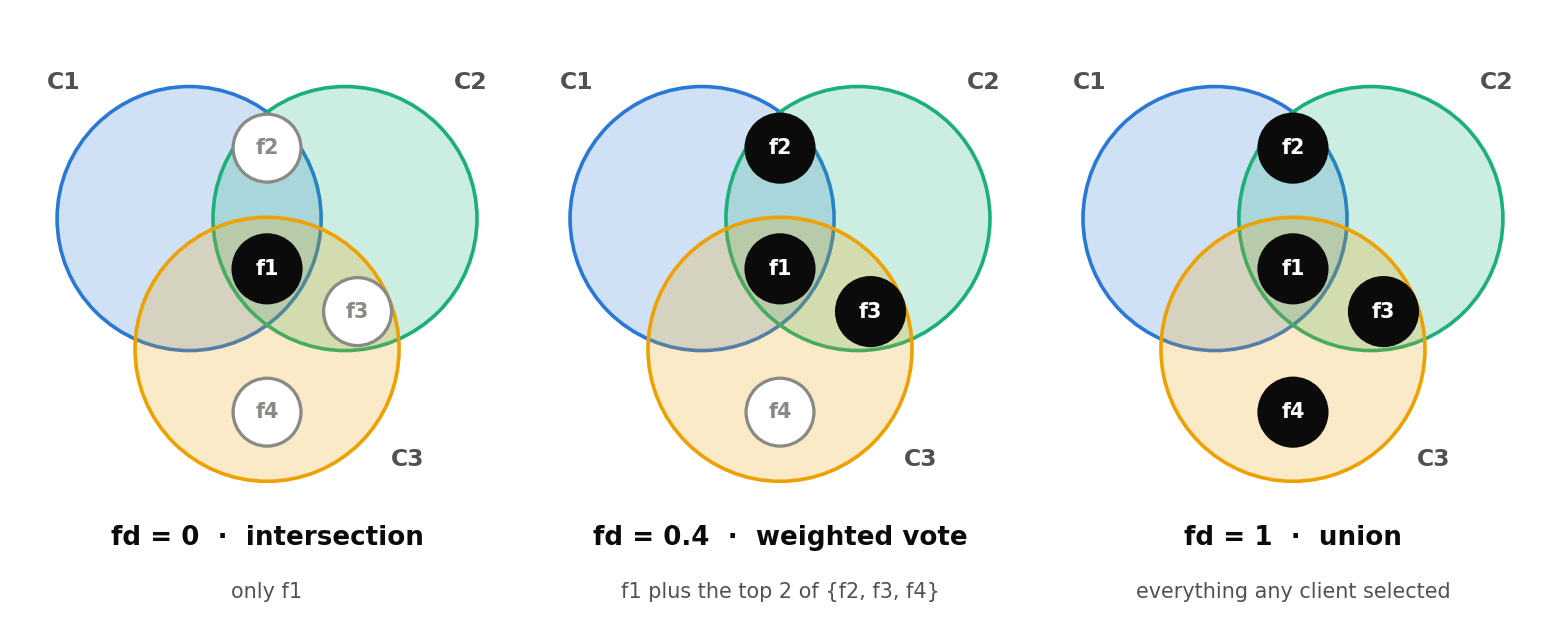
सर्वर वे फीचर रखता है जिन्हें सभी साइटों ने चुना है और उन्हें हटाता है जिन्हें किसी ने नहीं चुना। विवादित फीचर साइट के आकार से भारित वोटिंग में जाते हैं, और "फ्रीडम डिग्री" नाम का एक समायोज्य पैरामीटर तय करता है कि उनमें से कितने मॉडल में शामिल होंगे। इसके बाद हर साइट अपने कॉलमों पर परिणामी वैश्विक मास्क लागू करती है और कम किए गए टेबल पर सामान्य फेडरेटेड प्रशिक्षण चलता है।
यह तरीका NumPy में लागू किया गया है और NVIDIA FLARE में एक जॉब के रूप में प्रदर्शित किया गया है, साथ ही Flower के लिए भी कोड दिखाया गया है।
स्रोत: Towards Data Science · HeadlinesBriefing द्वारा सारांशित