
Krankenhäuser, Banken und Edge-Geräte wollen oft gemeinsam ein Modell trainieren, doch ihre Tabellen teilen zwar ein Schema, ihre Zeilen müssen aber privat bleiben. Dieses Szenario, das horizontale föderierte Lernen, stützt sich meist auf Fed Avg, das die Gewichte jedes Standorts mittelt. Fed Avg fragt nie, welche Merkmale in das Modell gehören, sodass jede irrelevante Spalte in jede Aktualisierung mitgeschleppt wird und Rauschen hinzufügt, das kleinere Standorte am stärksten spüren.
Feature Election, eine Methode, die für diese Lücke entwickelt wurde, verlangt weniger als die meisten Forschungsarbeiten zur föderierten Merkmalsauswahl. Anstatt einen neuen, eigens entwickelten Algorithmus zu übernehmen, behält jeder Standort den gewöhnlichen Selektor, dem er vertraut, etwa Lasso, Random-Forest-Wichtigkeiten oder gegenseitige Information, führt ihn auf seinen eigenen Zeilen aus und sendet eine Stimme. Jeder Standort sendet eine binäre Maske der behaltenen Merkmale, einen Vektor von Präferenzwerten und seine Stichprobenzahl. Während der Wahl verlassen weder Zeilen noch Gradienten den Standort.
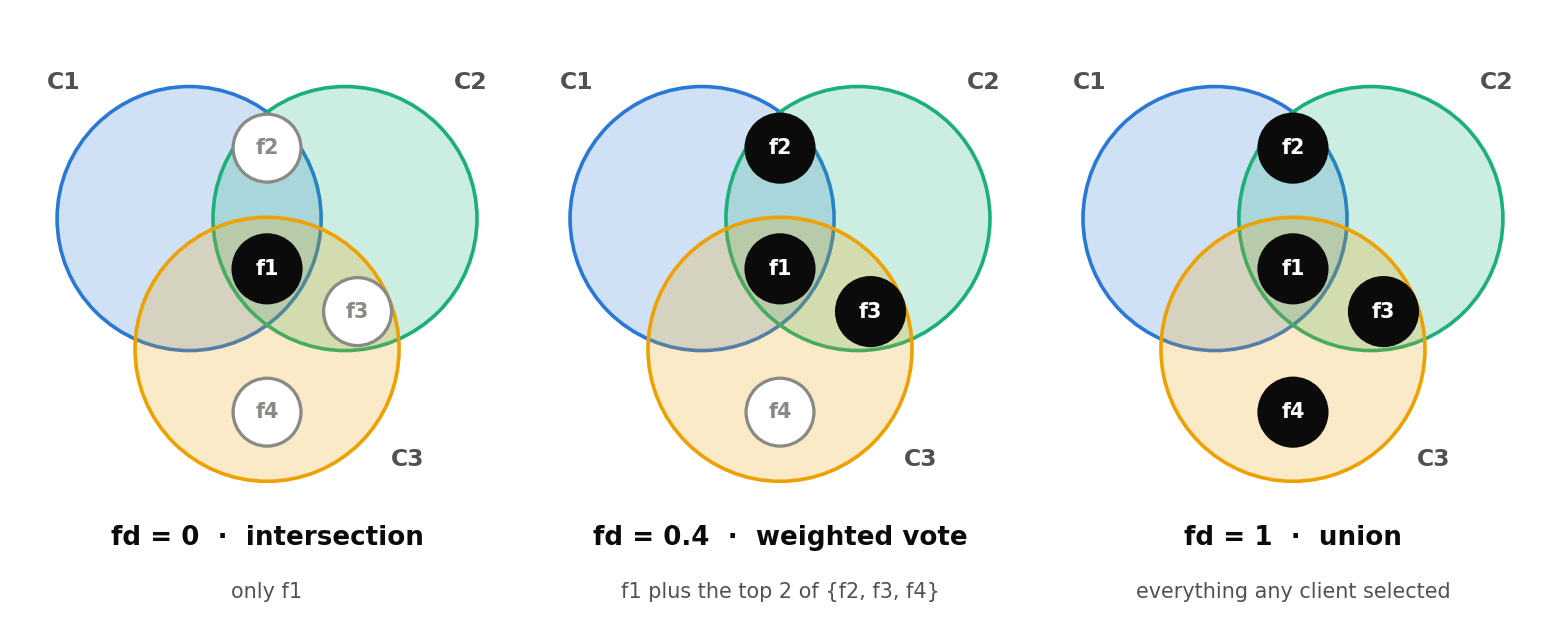
Der Server behält Merkmale, die alle Standorte gewählt haben, und verwirft solche, die kein Standort gewählt hat. Umstrittene Merkmale gehen in eine nach Standortgröße gewichtete Abstimmung, und ein einstellbarer Parameter namens Freiheitsgrad bestimmt, wie viele davon ins Modell eingehen. Danach wendet jeder Standort die resultierende globale Maske auf seine Spalten an, und das übliche föderierte Training läuft auf der reduzierten Tabelle.
Der Ansatz ist in NumPy implementiert und wird als Job in NVIDIA FLARE vorgeführt, außerdem ist Code für Flower gezeigt.
Quelle: Towards Data Science · Zusammengefasst von HeadlinesBriefing