
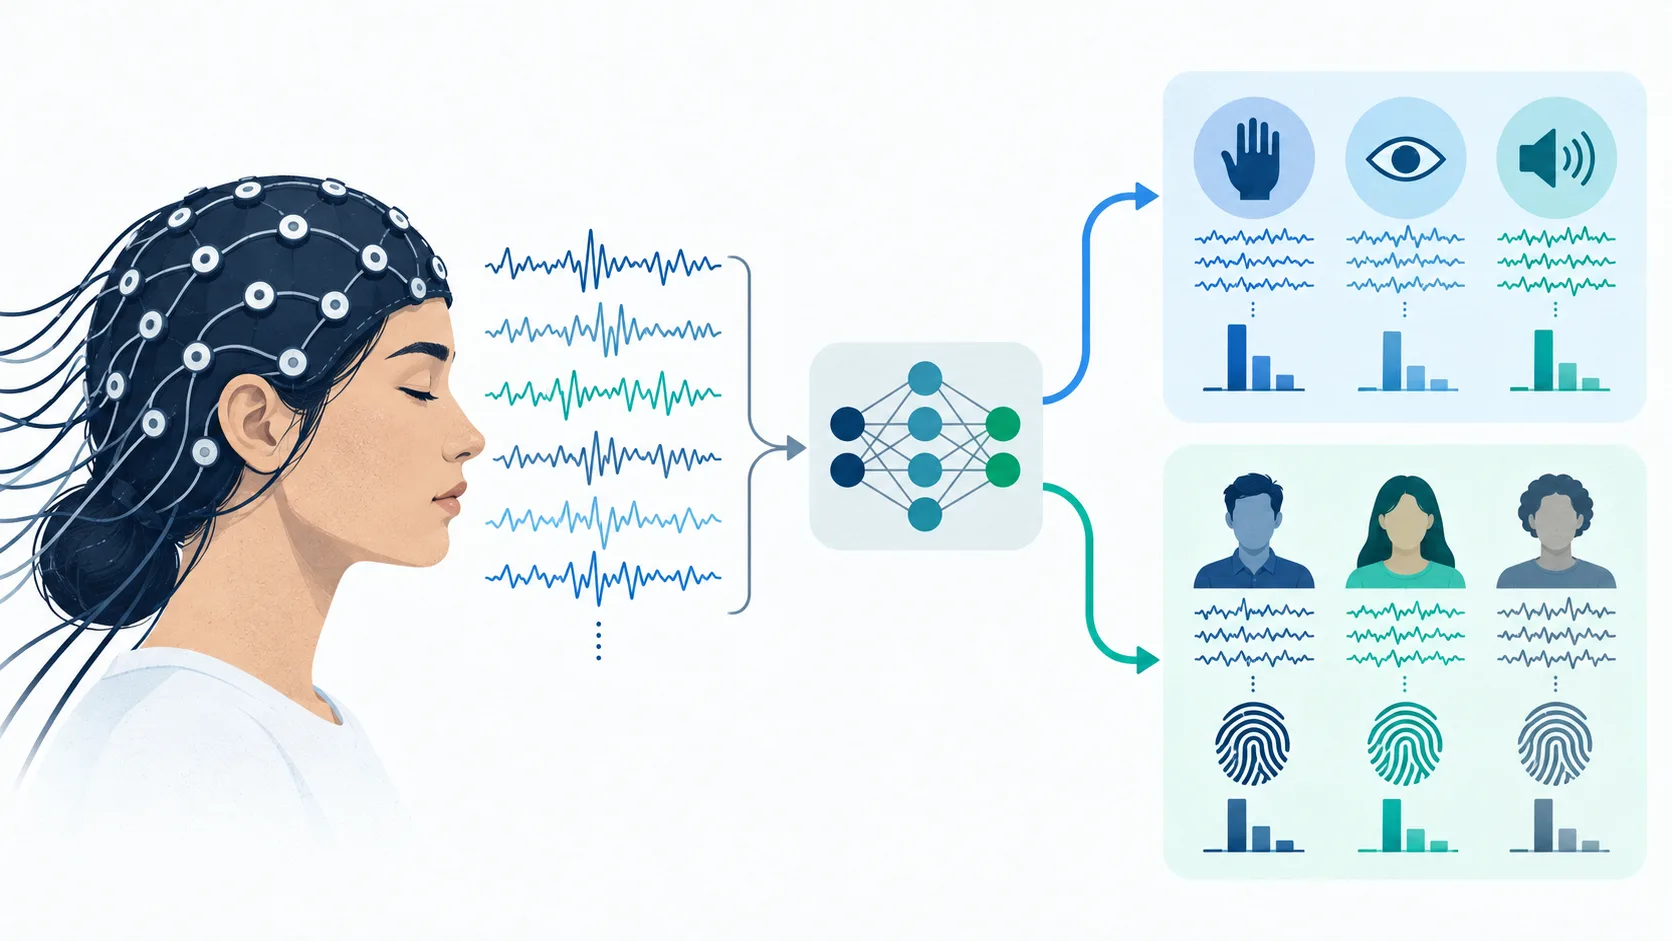
EEGの機械学習パイプラインを構築する際、同じ被験者が訓練データとテストデータの両方に含まれていると、データをランダムなウィンドウに分割することで誤解を招くほど楽観的な結果が得られることがあります。この方法では、新しい被験者への真の汎化能力は検証できません。モデルがタスクに関連する信号ではなく、被験者固有のパターンを学習してしまう可能性があるためです。この問題はEEGに限ったことではなく、ウェアラブルセンサーや行動データなど、同一の情報源から反復測定を行うあらゆる分野に当てはまります。
本研究では、研究者らが簡単なEEG実験を再現しました。安静状態と暗算課題のデータを比較し、スペクトル特徴量と3つの標準的な機械学習アルゴリズムを用いました。ランダムウィンドウ分割と、被験者単位で訓練またはテストのどちらか一方に割り当てる被験者ホールドアウト評価を対比しました。使用したデータセットはPhysio NetのEEG During Mental Arithmetic Tasks(EEGMAT)で、36件の記録(18名の被験者、それぞれ安静状態と暗算の記録)を含みます。フィルタリングとウィンドウ化の後、4秒の窓2,134個を抽出しました。内訳は安静状態1,594個、暗算540個です。19のEEGチャネルにおける4つの周波数帯の相対パワーにより、窓ごとに76の特徴量を得ました。この分析の目的は新しいバイオマーカーの開発ではなく、評価手法の影響を切り分けることにあり、そのため従来の特徴量を用い、クラスのバランスと特徴量の識別力を統制しました。
結果として、被験者を考慮した評価は性能推定値を大きく変化させることがわかりました。被験者固有の構造が存在する場合、標準的なランダム分割ではモデルの汎化性能が過大評価されることが示されました。
出典: Towards Data Science · 要約:HeadlinesBriefing